
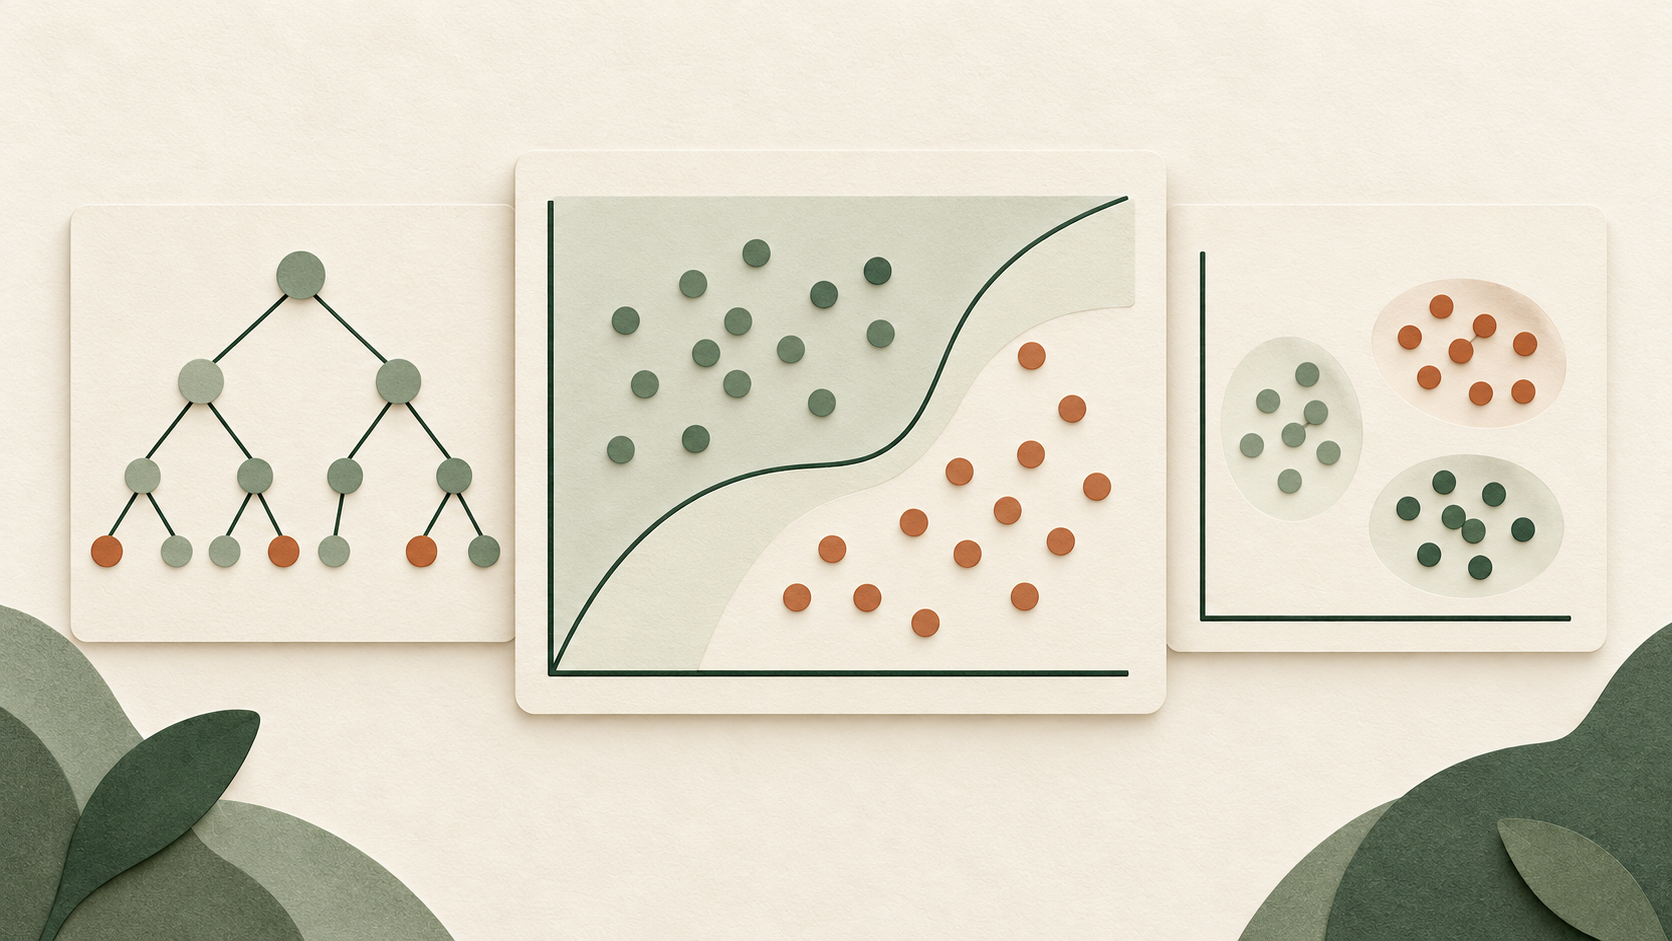
Классическое машинное обучение: алгоритмы и практика на Python
Научитесь выбирать и настраивать модели машинного обучения на Python: от линейной регрессии до случайного леса, бустинга и SVM. Кросс-валидация, Pipeline, работа с признаками и два итоговых проекта на scikit-learn.
О курсе
Первую модель вы уже обучили. Теперь пора разобраться, какую модель выбрать для новой задачи, какие параметры менять и как проверить, что результат действительно стал лучше.
В этом курсе вы последовательно разберёте основные алгоритмы классического машинного обучения и сравните их на данных. Почему линейной модели бывает достаточно? Когда дерево переобучается? Как масштаб признаков влияет на ближайших соседей и SVM? Объяснения, числовые примеры и код помогут связать устройство алгоритма с его предсказаниями.
От алгоритмов к выбору модели
Линейная и логистическая регрессия, Ridge и Lasso, kNN, деревья решений, случайный лес, градиентный бустинг и метод опорных векторов. Для каждого семейства — принцип работы, основные настройки и задачи, в которых его стоит попробовать.
Отдельно разберём подготовку признаков и оценку качества: пропуски и категории, масштабирование внутри Pipeline, кросс-валидацию и подбор параметров через GridSearchCV. Вы поработаете с данными, где нельзя просто перемешать строки: с временной последовательностью и повторяющимися объектами.
Больше, чем точность на тестовой выборке
При классификации важны и вероятности, и цена ошибки. Вы научитесь читать ROC- и PR-кривые, проверять калибровку и выбирать порог с учётом стоимости пропуска и ложной тревоги. В блоке обучения без учителя — KMeans, DBSCAN и PCA: поиск групп объектов и снижение размерности.
Два проекта в конце курса
- Регрессия: сравните модели на данных с временной структурой, оцените ошибки и подготовите итоговый отчёт.
- Классификация: построите прогноз отказа устройства, проверите вероятности и выберете порог по заданной цене ошибок.
На выходе у вас будет опыт полного эксперимента: от разбиения данных и простого baseline до выбора модели, финальной проверки и объяснения результата.
Чему научитесь
- Выбирать между линейными моделями, kNN, деревьями, случайным лесом, бустингом и SVM для задач регрессии и классификации.
- Готовить признаки и собирать Pipeline, чтобы преобразования обучались только на обучающих данных.
- Сравнивать модели с помощью кросс-валидации и подбирать параметры через GridSearchCV.
- Разделять временные и групповые данные, не допуская пересечения связанных наблюдений между обучением и проверкой.
- Оценивать вероятности, работать с дисбалансом классов и выбирать порог по цене ошибок.
- Применять KMeans, DBSCAN и PCA, проверяя, какую пользу они дают на конкретных данных.
- Проводить полный ML-эксперимент и объяснять выбор модели, её ошибки и ограничения.
Для кого
- Тем, кто уже обучил первую модель и хочет разобраться в основных алгоритмах ML.
- Аналитикам и разработчикам, которые хотят решать задачи прогноза и классификации на табличных данных.
Формат
- 45 текстовых уроков с объяснениями, графиками и примерами кода на Python.
- Практические задания по темам курса и два итоговых проекта.
- Учебные CSV-файлы и словари полей прикреплены к урокам.
Что нужно на старте
- Базовый Python: функции, условия, циклы, коллекции и импорты.
- NumPy и pandas: массивы и таблицы, индексация, чтение CSV, простые группировки.
- Опыт обучения первой модели в scikit-learn: fit, predict, train_test_split и основные метрики. Подойдёт вводный курс «Машинное обучение с нуля на Python: первая модель» или аналогичная подготовка.
Автор курса
Алексей Малышкин
Разрабатываю образовательные материалы по программированию, машинному обучению и анализу данных. Темы: Python-разработка, аналитика, ML-инструменты (LangChain, vector databases, AI agents), компьютерное зрение. Стараюсь объяснять технические концепции понятно и структурировано. Ранее преподавал на Stepik и обучил более 2000 студентов. Мой профиль на Stepik - https://stepik.org/users/273781420/profile Мой телеграм для связи @alexey_latorn

