
Урок курса
Realtime speech-to-speech: как устроено и когда использовать
Voice AI Agents PROКлассический подход vs нативный realtime
Каскадный пайплайн строится на последовательности независимых сервисов. Голос клиента проходит три отдельных шага: STT превращает аудио в текст, LLM обрабатывает текст и генерирует ответ, TTS синтезирует текст обратно в голос. На каждом стыке — сетевой запрос и преобразование формата. Задержки складываются.
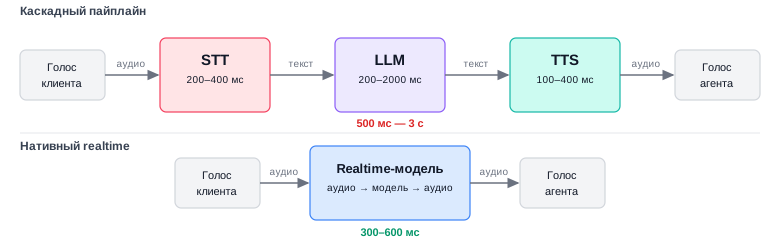
Нативные речевые модели устраняют эти стыки. Модель принимает аудиопоток напрямую и возвращает аудиопоток — без промежуточного текста. Нет отдельного STT, нет отдельного TTS, нет трёх сетевых вызовов. Одна модель ведёт весь разговор от начала до конца.
Разница в задержке: 300–600 мс против 500 мс–3 секунды в каскаде. Не потому что компоненты стали быстрее — шагов просто меньше. Клиент заканчивает говорить — и почти сразу слышит ответ.
Что слышно на практике
Один и тот же агент в Vapi.ai с нативной realtime-моделью GPT-Realtime-2 — два звонка на разных языках, настройки по умолчанию. Что-то подобное вы получите при первом запуске, без тонкого тюнинга.
В русском варианте задержки 1–3 секунды и заметный акцент. Нынешние realtime-модели обучены преимущественно на английском: русский поддерживается, но по качеству голоса пока уступает.
В английском варианте слышно главное свойство нативного realtime: агент начинает говорить раньше, чем клиент закончил мысль. Сказал «Sure», начал следующее слово и оборвал себя на полуслове — в записи слышно «ame…». Через секунду переключился: «I see you're thinking about Monday.» Это не сбой — модель начала отвечать до конца реплики и скорректировала ответ на ходу. Задержка минимальная, но звучит неестественно: живой собеседник так не говорит.
В каскадном пайплайне таких артефактов нет: LLM сначала генерирует текст целиком, TTS его озвучивает. Собеседник слышит законченную фразу — но ждёт дольше.
Как устроена realtime-сессия
Событийная модель
Вместо запросов и ответов здесь поток событий через открытый WebSocket или WebRTC-канал. Приложение непрерывно передаёт аудио, модель обрабатывает его и отправляет события обратно. Ниже — имена событий OpenAI Realtime API; у Gemini Live API своя модель сообщений с другими названиями, принцип тот же.
- input_audio_buffer.append (только WebSocket) — приложение передаёт очередной аудиочанк (PCM, 16-битный моно, 24 000 Гц). При работе через WebRTC аудио идёт через медиатрек; явный
appendне используется. - input_audio_buffer.speech_started / input_audio_buffer.speech_stopped — встроенный VAD (Voice Activity Detection — детектор голосовой активности) зафиксировал начало и конец реплики клиента.
- response.output_audio.delta — модель возвращает фрагмент синтезированного ответа, приложение сразу его воспроизводит.
- response.function_call_arguments.delta — модель решила вызвать инструмент; приложение выполняет вызов и возвращает результат.
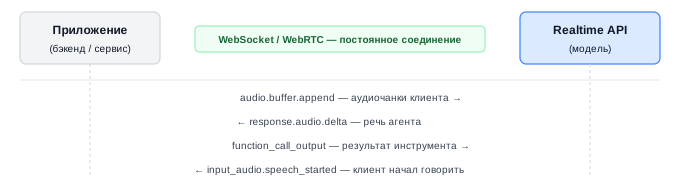
Событие input_audio_buffer.speech_started — триггер прерывания. Если клиент начинает говорить, пока агент ещё отвечает, модель останавливает генерацию аудио — детектирование встроено в сессию, VAD писать не нужно. Но приложение всё равно отвечает за прикладную часть: остановить воспроизведение уже отправленных чанков, очистить очередь и сбросить буфер вывода. Без этого клиент дослушает старый ответ до конца. В каскадном пайплайне весь этот уровень — VAD, отмена TTS-генерации, сброс буферов — писался вручную с нуля.
Состояние хранит сессия
В каскаде история диалога передаётся явно при каждом обращении к LLM. В нативном realtime история разговора — в сессии, в пределах контекстного окна модели. Приложение не собирает массив сообщений явно. Бизнес-состояние — что клиент уже заказал, какая запись создана, статус обращения — хранит само приложение: в сессии его нет, модель работает только с тем, что передано через системный промпт или инструменты.
Инструкции агента, список инструментов и голосовые параметры задаются один раз при инициализации. При необходимости их можно изменить в ходе разговора, не разрывая соединение.
Tool calling в живом звонке
Модель вызывает инструменты, не прерывая аудиопоток. Пока приложение проверяет расписание в CRM или создаёт запись — сессия остаётся открытой. Модель получает результат и продолжает разговор с того же места.
На время выполнения инструмента аудиогенерация приостанавливается. GPT-Realtime-2 поддерживает preambles — модель произносит короткую фразу до результата инструмента ("проверяю", "секунду"), и клиент не слышит тишины. Без preamble пауза на тяжёлый инструмент становится заметной. Быстрые операции (чтение из кэша, простой API-запрос) — до 500 мс; более тяжёлые — выносить за пределы звонка или отдавать результат в два этапа.
Tool calling в нативных realtime audio-сессиях поддерживают GPT-Realtime-2, Gemini Live API и Yandex Realtime API (AI Studio, русский и казахский язык). YandexGPT и GigaChat поддерживают function calling только в каскадном режиме.
Прерывания и end-of-turn detection
Два механизма определяют, насколько разговор с агентом звучит естественно: barge-in — возможность клиента перебить агента — и end-of-turn detection — точное определение момента, когда клиент закончил говорить.
Barge-in: в каскаде и в realtime
В каскадном пайплайне прерывание — отдельная инженерная задача. Нужно запустить VAD параллельно с воспроизведением аудио, при обнаружении голоса остановить вывод TTS, сбросить очередь воспроизведения, отменить текущий запрос к LLM и начать новый цикл распознавания. Каждый из этих шагов — отдельная интеграция, и любой из них может дать сбой: агент перебивает клиента, не дождавшись конца фразы, или продолжает говорить, не реагируя на возражение.
В нативном realtime-агенте детектирование прерывания встроено: событие input_audio.speech_started останавливает генерацию ответа на стороне модели — отдельный VAD писать не нужно. Но остановить воспроизведение аудио, которое уже ушло в буфер клиента, — задача приложения. Это сброс очереди воспроизведения и отмена незавершённых чанков: несколько строк кода, но пропустить их — значит, клиент услышит наложение старого ответа на новую реплику агента.
End-of-turn detection: тишина vs смысл
В каскаде конец реплики определяет VAD по энергии сигнала: если пауза длиннее 600–800 мс — считаем, что клиент закончил. Это работает на простых коротких фразах, но ломается на распространённых паттернах живой речи:
- клиент перечисляет через «и-и-и...» или «то есть...» — VAD срезает, LLM получает половину мысли;
- медленная речь или акцент — пороговый таймаут подобран неправильно;
- клиент сделал паузу, задумавшись — агент начинает отвечать раньше времени.
Третий паттерн из этого списка хорошо слышен в записи из первого шага: агент отреагировал на паузу клиента, начал отвечать — и пришлось корректировать ответ на ходу, оборвав себя на полуслове.
Нативная модель определяет конец реплики по содержанию, а не только по тишине. Незаконченное предложение — модель ждёт. Завершённый вопрос с паузой в конце — отвечает. Это снижает число ситуаций, когда агент отвечает на незавершённую мысль или молчит, дожидаясь тишины, которая уже была.
Практический итог: реализовать нормальный разговор — с прерываниями и паузами в нужных местах — в нативном realtime значительно проще, чем в каскаде. Меньше кода, меньше граничных случаев, меньше регрессий при изменении сценария.
Когда realtime, а когда каскад
Нативный realtime не вытесняет каскад — они решают разные задачи. Выбор зависит от трёх критериев: требования к данным, сложность диалога и стоимость.
Данные и российский контур
С 2025 года Yandex предлагает Realtime API в AI Studio — нативные аудиосессии на русском языке в российском облаке. Для проектов, где данные не должны покидать РФ, работают оба варианта: Yandex Realtime API и каскад на Yandex SpeechKit + YandexGPT + Yandex TTS. Выбор между ними определяется сложностью диалога и требованиями к качеству голоса, а не законодательством. Realtime от OpenAI или Google — другой вопрос: их серверы за пределами РФ, и это действительно закрывает вопрос для проектов с жёсткими требованиями к размещению данных.
Сложность диалога и поведение при прерываниях
Realtime выигрывает на консультациях, живых беседах и сценариях с частыми прерываниями. Клиент перебил агента на полуслове, уточнил вопрос, передумал — всё обрабатывается без инженерных усилий.
Но у нативного realtime есть текущие ограничения, которые стоит учитывать. Модель начинает говорить до завершения мысли — и иногда обрывает себя на полуслове, когда получает новую информацию. Это слышно и в записи из первого шага. Тюнинг параметров VAD снижает частоту таких случаев, но не устраняет их полностью: потоковая генерация — архитектурное свойство, а не баг конфигурации. На русском языке добавляется заметный акцент и задержки 1–3 секунды: нынешние realtime-модели обучены преимущественно на английском, и это не решается настройками.
Нативный realtime появился в публичном доступе в конце 2023 года. Технология развивается быстро, но до неотличимости от живого разговора — особенно на русском — ещё есть расстояние. Если клиент ожидает человеческое качество голоса, стоит честно обозначить ожидания заранее.
Каскад справляется с простым скриптом: напоминание о записи, подтверждение доставки, опрос NPS. Клиент отвечает коротко и по делу, агент не отклоняется от сценария, прерывания редки. В этом сценарии дополнительная сложность realtime не нужна.
Стоимость
Realtime-сессии тарифицируются по-другому, чем отдельные API-вызовы. На исходящем автообзвоне с коротким скриптом дешёвый STT + быстрый LLM + потоковый TTS обходятся дешевле. Realtime оправдан там, где нужна живая беседа, а не воспроизведение скрипта.
Ориентиры выбора
- Данные хранятся в РФ, требования 152-ФЗ — российские сервисы: Yandex Realtime API или каскад на Yandex SpeechKit + YandexGPT + Yandex TTS.
- Живая консультация, частые прерывания, сложный диалог (англоязычная аудитория) — нативный realtime (GPT-Realtime-2).
- Живая консультация на русском, данные в российском облаке — Yandex Realtime API (AI Studio).
- Живая консультация на русском, высокие требования к качеству голоса — каскад с выделенным TTS; GPT-Realtime-2 на русском звучит с заметным акцентом.
- Исходящий скриптовый обзвон — каскад (достаточно для задачи, дешевле).
- No-code платформа, быстрый старт — Vapi и аналоги строят realtime-инфраструктуру сами; разбираем позже в курсе.
Каскад и realtime — два инструмента с разными применениями. Выбор определяется требованиями к данным, сложностью диалога и стоимостью, а не архитектурной модой.
Задача 1
Что в нативном realtime-агенте отсутствует как отдельный компонент по сравнению с каскадным пайплайном?
Задача 2
Какова типичная задержка нативного realtime-агента на английском языке — от момента, когда клиент замолчал, до начала ответа?
Задача 3
Почему barge-in в нативном realtime-агенте реализовать проще, чем в каскадном пайплайне?
Задача 4
Сопоставьте событие OpenAI Realtime API с его описанием.
Сопоставьте элементы
Задача 5
Расставьте события OpenAI Realtime API в порядке обработки одной реплики клиента.
Расположите элементы в правильном порядке
- 1.Приложение воспроизводит ответ клиенту
- 2.response.output_audio.delta — модель возвращает аудиоответ
- 3.input_audio_buffer.speech_stopped — VAD зафиксировал конец речи
- 4.input_audio_buffer.speech_started — VAD зафиксировал начало речи
- 5.input_audio_buffer.append — приложение передаёт аудиочанки
Задача 6
В каком сценарии каскадный пайплайн предпочтительнее нативного realtime-агента согласно материалу урока?
Продолжить с сохранением прогресса
Перейдите к уроку в учебном кабинете.

