
Урок курса
Классический пайплайн: STT — LLM — TTS
Voice AI Agents PROГолосовой агент: что это такое и почему сейчас
Голосовой агент — это программа, которая ведёт телефонный разговор самостоятельно: слышит клиента, понимает смысл сказанного, принимает решение и отвечает живой речью. Не IVR (Interactive Voice Response — автоответчик с голосовым меню: «нажмите 1, нажмите 2»), не бот в мессенджере — именно голосовой разговор в реальном времени.
До недавнего времени такие системы строились только крупными компаниями с командами ML-инженеров и многомиллионными бюджетами. С 2023–2024 годов ситуация изменилась: облачные STT и TTS подешевели в разы, доступные LLM научились вести связный диалог, а платформы вроде Vapi и Voiceflow снизили порог входа до уровня одного разработчика. Теперь голосового агента для небольшой клиники или интернет-магазина можно запустить за несколько дней.
Где это уже работает в России
Голосовые агенты в российском бизнесе покрывают три основных сценария:
- Входящие обращения — запись к врачу, статус заказа, информация о балансе. Агент снимает нагрузку с операторов на однотипных запросах, которые составляют 60–80% входящего потока.
- Исходящий обзвон — напоминания о записи, подтверждение доставки, опросы NPS (Net Promoter Score — оценка удовлетворённости клиента по шкале от 0 до 10). Стоимость одного исходящего звонка голосовым агентом на порядок ниже, чем у оператора колл-центра — разница особенно заметна при больших объёмах обзвона.
- Квалификация лидов — первичный контакт с входящей заявкой: агент задаёт несколько вопросов, квалифицирует клиента и передаёт его оператору с заполненной карточкой.
Российский рынок голосовых AI-агентов активно растёт: крупные компании внедряют их для снижения нагрузки на колл-центры, стартапы предлагают готовые отраслевые решения. Основные игроки — Yandex SpeechKit, Сбер Salute, Naumen, ЦРТ (Центр Речевых Технологий) — работают давно. С 2023–2024 годов к ним добавились десятки продуктов, построенных на базе западных API.
OpenAI и Россия. С июля 2024 года OpenAI официально заблокировал доступ для российских IP-адресов. API при этом технически работает — через VPN или Azure OpenAI Service (Microsoft), который Россию не блокирует. В курсе мы будем использовать OpenAI API с этой оговоркой. Для проектов, где данные не должны покидать РФ, разбираем отечественные альтернативы: YandexGPT, GigaChat.
Что вы разберёте в этом курсе
Курс строится вокруг двух архитектур, которые встречаются в продакшне рядом. Первая — каскадный пайплайн: STT → LLM → TTS. Три независимых компонента, полный контроль, российские сервисы, гибкость под требования к хранению данных. Разбирается последовательно в первой части курса: STT, TTS, бюджет задержки, LLM-слой, фреймворки оркестрации.
Вторая — нативные realtime-агенты на GPT-Realtime-2: живая аудиосессия без отдельных STT и TTS, прерывания в реальном времени, tool calling прямо в звонке, задержка 300–600 мс. Ему посвящён отдельный большой блок курса.
Дальше — телефония, платформы без кода, Voice RAG, тестирование агентов на реальных звонках, российский стек и кейсы по отраслям. Путь: от понимания того, что происходит внутри звонка — к агенту, который реально работает в бизнесе.
Этот урок — фундамент. Он разбирает каскадный пайплайн: что происходит за те секунды, пока клиент ждёт ответа. Это нужно понять, чтобы потом видеть разницу между каскадным подходом и realtime.
Как звучит реальный агент
Послушайте пример: агент записывает пациента на приём, уточняет удобное время и контактные данные. Весь разговор — чуть более минуты, ни один оператор к нему не подключался.
Vapi — одна из ведущих платформ для запуска голосовых агентов. Она берёт на себя всю инфраструктуру: STT, LLM, TTS, телефонию — разработчику остаётся только описать сценарий и выбрать голос. Зарегистрироваться можно бесплатно — новым пользователям начисляется 10 кредитов, которых хватает на несколько минут тестовых звонков, карта не нужна. После каждого звонка в личном кабинете сохраняется запись, транскрипт и стоимость.
Классический подход: три блока, одна цепочка
Исторически сложившаяся архитектура голосового агента — каскадный пайплайн из трёх независимых компонентов, которые передают данные друг другу последовательно.
Что происходит внутри одного звонка
Клиент говорит: «Свободна ли запись на 15:00 на завтра?». Вот что происходит за следующие секунды:
- STT (Speech-to-Text) слышит голос и превращает его в текст:
"Свободна ли запись на 15:00 на завтра?". - LLM (Large Language Model) получает этот текст вместе с историей диалога, решает вызвать функцию проверки расписания, получает ответ из CRM и генерирует реплику:
"Завтра в 15:00 свободно, записать вас?" - TTS (Text-to-Speech) превращает эту строку в голос и отправляет клиенту.
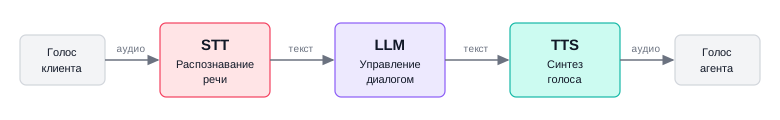
На стыках данные меняют формат: аудио → текст → текст → аудио. Каждый компонент — отдельный сервис с понятным интерфейсом. Следующие три шага разбирают STT, LLM и TTS по отдельности.
Главное преимущество этой архитектуры — гибкость: можно выбирать компоненты независимо, заменять один провайдер без переделки остальных, использовать российские сервисы там, где требует 152-ФЗ. Главный недостаток — суммарная задержка: аудио проходит три отдельных сервиса, каждый добавляет время. Как с этим работает альтернативный realtime-подход — в следующем уроке.
Ошибки в цепочке суммируются
STT вернул мусор — LLM коротко ответит, что не понял вопроса. LLM вернул markdown — TTS зачитает звёздочки и маркеры вслух. Проблема проявляется в конце цепочки, а причина — в начале или середине. Это значит, что диагностировать нужно с первого компонента
STT: как агент слышит клиента
Входящий звонок — это аудиопоток. STT-движок преобразует его в текст. Именно здесь чаще всего ломаются продакшн-агенты при первом контакте с реальной телефонией.
Как устроено распознавание внутри
Современные STT-системы работают на основе нейросетевых архитектур — преимущественно трансформеров. Процесс выглядит так:
- Аудиопоток делится на перекрывающиеся фреймы по 20–40 мс.
- Из каждого фрейма извлекаются акустические признаки — числовое представление звука, удобное для нейросети.
- Энкодер нейросети преобразует последовательность признаков в скрытые представления.
- Декодер предсказывает наиболее вероятную последовательность токенов (букв, слогов или слов).
- Языковая модель (LM) корректирует результат с учётом контекста: акустически похожее «яндекх» исправляется на «Яндекс» как более вероятное слово в данном контексте.
Большинство российских облачных STT-сервисов используют сквозное обучение (end-to-end), где вся цепочка от акустики до текста — единая нейросеть. Whisper от OpenAI — одна из таких моделей, доступная для локального развёртывания.
VAD, end-of-turn и barge-in: как агент понимает очередь в разговоре
До того как текст уйдёт в LLM, срабатывает отдельный компонент — VAD (Voice Activity Detection). Его задача — определить, есть ли сейчас речь в канале. Но в продакшне этого мало.
Полная очерёдность реплик в разговоре складывается из четырёх задач:
- VAD — есть ли речь прямо сейчас. Работает по энергии сигнала и спектральным признакам, отличает речь от тишины и фонового шума.
- End-of-turn detection — закончил ли пользователь мысль. Пауза в речи не всегда означает конец реплики: клиент может делать паузы внутри фразы. Современные STT-сервисы (SaluteSpeech, GPT-Realtime-2) решают это на уровне модели, а не только порога тишины.
- Barge-in / interruption — клиент перебивает агента. Система должна остановить TTS, принять новую реплику и продолжить диалог. Без поддержки barge-in агент зачитывает ответ до конца, даже если клиент уже сказал что-то важное.
- Backchannel / preamble — агент даёт короткую фразу-подтверждение ("секунду, проверяю") пока обрабатывает запрос, чтобы клиент не решил, что связь оборвалась.
Ошибки на уровне порога тишины дорого стоят:
- Слишком ранний срез — клиент ещё не договорил, LLM получает обрезанную фразу и отвечает невпопад.
- Слишком поздний срез — агент держит паузу дольше необходимого, диалог ощущается как зависший.
Большинство STT-API позволяют настроить порог тишины (silence_duration_ms) — время паузы, после которого считается, что реплика завершена. Оптимальное значение для телефонии — 600–800 мс; меньше — слишком много ложных срабатываний, больше — агент кажется тугодумом.
Что влияет на качество распознавания
Четыре фактора определяют точность STT в реальных звонках:
- Качество связи и шум. Звонок с мобильного на улице и звонок с VoIP-гарнитуры в тихом офисе — это разные задачи для модели. Мобильная телефония (кодек G.711, 8 кГц) режет верхние частоты, что снижает разборчивость согласных.
- Акцент и диалект. Модели, обученные преимущественно на московском произношении, заметно чаще ошибаются на региональных акцентах и нестандартном произношении.
- Отраслевая лексика. Названия препаратов, артикулы деталей, юридические термины — распознаются хуже общеупотребительных слов. Yandex SpeechKit и Salute Speech поддерживают пользовательские словари для адаптации модели к конкретной предметной области.
- Длина и структура реплики. Короткие чёткие фразы («Запишите меня на вторник») распознаются лучше, чем длинные с вводными словами и паузами. Это важно учитывать при проектировании сценария: агент должен задавать узкие вопросы, а не ждать монолога клиента.
Метрики качества STT
WER (Word Error Rate) — основная метрика распознавания речи. Считается как:
- — замены слов
- — пропуски
- — вставки
- — общее число слов в эталоне
Ориентиры для русского языка:
- Чистая студийная речь: WER 3–8%
- Телефония без шума: WER 8–15%
- Телефония с фоновым шумом: WER 20–40%
Каждый процент WER прямо влияет на то, насколько точно LLM поймёт запрос клиента. При WER 30% каждое третье слово распознано неправильно — агент начинает отвечать на то, чего клиент не говорил.
CER (Character Error Rate) — то же самое, но считается на уровне символов, а не слов. Для русского языка иногда точнее отражает реальное качество: из-за сложной морфологии одно неверное окончание даёт ошибку в слове, но затрагивает лишь один-два символа.
RTF (Real-Time Factor) — отношение времени обработки к длине аудио. RTF = 0.3 означает, что одна секунда звука обрабатывается за 0.3 секунды. Для продакшн-агента RTF должен быть меньше 1 — иначе движок физически не успевает за звонком. WER ничего об этом не говорит, поэтому при выборе STT-сервиса смотрят на обе метрики.
Для российских проектов доступны: Yandex SpeechKit (сильнее всего на русской телефонии), Salute Speech (Сбер, есть on-premise вариант), TinkoffVoice и локально развёртываемый Whisper от OpenAI.
LLM: логика диалога
Текст от STT поступает в языковую модель. Задача LLM в голосовом агенте — не генерация длинных текстов, а ведение короткого целенаправленного диалога: уточнить детали, подтвердить выбор, выбрать ветку сценария, вызвать внешнюю функцию.
Что получает модель на каждом шаге диалога
На каждом ходу диалога LLM получает три составляющих в одном запросе:
- Системный промпт — инструкция агента: роль, ограничения, сценарий, формат ответов. Единственное место, где разработчик полностью контролирует поведение модели.
- История диалога — все предыдущие реплики клиента и агента. LLM не хранит состояние между запросами — история передаётся заново при каждом обращении.
- Текущая реплика — результат STT для последней фразы клиента.
Инструменты: агент vs чатбот
LLM без инструментов уже может отвечать на вопросы, консультировать по скрипту, обрабатывать FAQ — для ряда сценариев этого достаточно. Инструменты нужны там, где агент должен что-то сделать: проверить расписание, создать запись в CRM, переключить звонок на оператора, отправить SMS-подтверждение.
Принцип один у всех провайдеров: вместо текстового ответа модель возвращает структурированный вызов, приложение его выполняет и возвращает результат обратно в диалог. Модель формирует финальную реплику уже на основе реальных данных.
Ограничения формата ответа
Ответ LLM передаётся в TTS и произносится вслух. Это жёсткое ограничение на формат: никакого markdown, никаких URL, никаких перечислений с маркерами и спецсимволов. Системный промпт должен явно запрещать форматирование и ограничивать длину реплик — иначе агент начнёт зачитывать вслух «звёздочки» и «пункт первый».
Практическое правило: реплика агента в продакшне не должна превышать 2–3 коротких предложения. Длинные монологи разрывают ощущение живого разговора.
Выбор модели для голосового агента
Разные LLM дают разное соотношение задержки, качества и стоимости:
- YandexGPT Pro / Lite — работает в российском облаке, данные не покидают РФ, хорошо понимает русскую речь; основной выбор для проектов под 152-ФЗ.
- GigaChat Pro (Сбер) — альтернатива YandexGPT, есть on-premise вариант для проектов с жёсткими требованиями к размещению данных.
- GPT-5.4 mini / GPT-5.4 nano — низкая задержка, дешёвые, подходят для большинства сценариев по скрипту; доступны через VPN или Azure OpenAI.
- GPT-5.5 — максимальное качество рассуждений, 1M токенов контекста, оправдан для сложных многошаговых диалогов.
- Локальные модели (Llama, Mistral) — данные не покидают сервер, нулевые переменные затраты; требуют инфраструктуры и обслуживания.
TTS и суммарная задержка пайплайна
Как работает синтез речи
Текстовый ответ LLM поступает в TTS-движок, который преобразует его в аудиопоток. Современные нейросетевые TTS-системы делают это быстро и качественно — на коротких фразах синтезированный голос практически неотличим от человеческого.
Для телефонии критично не только качество голоса, но и режим передачи аудио:
- Батчевый режим — движок получает весь текст, синтезирует полный аудиофайл, затем отдаёт его клиенту. Простой в реализации, добавляет задержку, пропорциональную длине текста. Для реплик длиннее 5–7 слов неприемлем в реальном времени.
- Потоковый режим (streaming) — движок начинает отдавать аудиочанки по мере синтеза, не дожидаясь конца текста. Клиент слышит начало фразы, пока синтезируется остаток. Снижает воспринимаемую задержку на 200–600 мс. Все продакшн-сервисы (Yandex TTS, ElevenLabs, OpenAI TTS) поддерживают streaming.
Что влияет на натуральность голоса
Качество синтезированной речи зависит от нескольких факторов:
- Архитектура модели. Старые TTS на основе склейки заранее записанных фрагментов звучат механически. Хорошие нейросетевые модели на коротких фразах дают речь, практически неотличимую от человеческой.
- Голос (voice). Коммерческие сервисы предлагают библиотеки готовых голосов — от нейтрального офисного до эмоционального. Yandex TTS позволяет клонировать голос по нескольким минутам записи.
- Просодия. Интонация, паузы, ударения. На длинных репликах нейросетевые TTS могут давать монотонность — особенно на числах, датах и перечислениях. Это одна из причин ограничивать длину реплик агента.
- Совместимость с телефонией. Телефонная линия работает с пониженным качеством звука. TTS должен отдавать аудио в совместимом формате или конвертироваться на лету — иначе возникнут проблемы со звуком на стороне клиента.
Суммарная задержка: предел, который нельзя превышать
Клиент заканчивает говорить — и ждёт ответа. Пауза складывается из трёх компонентов:
- STT + VAD: 200–600 мс
- LLM (время до первого токена, TTFT): 200–2000 мс
- TTS (время до первого аудиочанка): 100–400 мс
Итого: от 500 мс до 3 секунд до того, как клиент услышит первое слово ответа. Исследования UX-качества голосовых агентов показывают: паузы до 1,5 секунды воспринимаются как норма, 1,5–2,5 секунды — как замедленность, свыше 3 секунд — как сбой или зависание.
Этот предел — главный инженерный параметр при выборе стека. Быстрая дешёвая LLM с TTFT 300 мс и локальный TTS с минимальной задержкой могут дать суммарную паузу в 700–800 мс. Мощная модель с длинным временем генерации — 3+ секунды, даже при хорошем STT.
Каскадный пайплайн и realtime-агенты: два инструмента
Пока каскадный пайплайн собирает задержку на трёх стыках, существует другой класс решений — нативные realtime-агенты. Модели вроде GPT-Realtime-2 принимают аудиопоток напрямую и отвечают аудио, минуя отдельные STT и TTS. Суммарная задержка — 300–600 мс, модель держит состояние всей сессии, понимает прерывания клиента и может одновременно вызывать несколько инструментов.
С 2025 года Yandex предлагает Realtime API для голосовых агентов — первый российский сервис этого класса. Остальные российские провайдеры остаются на каскадной архитектуре.
У каскадного подхода при этом есть своя ниша, и она не маленькая. Когда данные не должны покидать российское облако — Yandex SpeechKit + YandexGPT + Yandex TTS работают в нём полностью, realtime-сессии OpenAI такого варианта не дают. Если нужен отраслевой словарь в STT или специфическое произношение в TTS — в каскаде каждый компонент меняется независимо. На исходящем автообзвоне с простым скриптом дешёвый STT + быстрая языковая модель + потоковый TTS зачастую дешевле realtime-сессий.
Это не вопрос «что лучше» — это два инструмента с разными применениями. GPT-Realtime-2 разбирается отдельно и подробно: архитектура сессий, события, tool calling и практика.
Что измерять при задержке голосового ответа
Разделите задержку на несколько наблюдаемых событий: конец речи пользователя, завершение распознавания, первый результат модели и первый воспроизведённый звук. Если измерять только длительность вызова LLM, задержка ожидания конца фразы и буферизации аудио останется невидимой.
Для одной реплики составьте временную шкалу. В последовательном STT → LLM → TTS примере стадии складываются, а в потоковой реализации могут перекрываться. Поэтому нельзя просто сложить времена завершения всех потоков и объявить это задержкой первого звука.
Проверьте короткую и длинную реплику, паузу внутри фразы и перебивание во время ответа. При barge-in важно остановить воспроизведение старого ответа и не допустить, чтобы его поздние фрагменты снова попали в аудио. Хорошая средняя latency не заменяет анализ длинного хвоста и ошибок отмены.
Продолжите разбор: Barge-in и latency budget: человечный диалог.
Задача 1
Чем голосовой агент принципиально отличается от IVR?
Задача 2
Голосовые агенты в российском бизнесе покрывают три основных сценария. Какой из перечисленных НЕ входит в их число?
Задача 3
Клиент заканчивает говорить. Расставьте события в правильном хронологическом порядке — от конца реплики клиента до момента, когда он услышит первое слово ответа агента.
Расположите элементы в правильном порядке
- 1.TTS начинает отдавать первые аудиочанки клиенту
- 2.LLM генерирует текстовый ответ
- 3.STT преобразует аудиофрагмент в текст
- 4.VAD фиксирует паузу и завершает захват аудио
Задача 4
Сопоставьте термин с его точным определением в контексте голосового агента.
Сопоставьте элементы
Задача 5
Какой порог тишины (silence_duration_ms) считается оптимальным для VAD в телефонии?
Задача 6
STT-сервис показывает WER 30% на тестовой выборке. Что это означает для работы голосового агента?
Задача 7
Какие факторы влияют на точность STT в реальных звонках? Выберите все верные варианты.
Задача 8
Что LLM получает при каждом обращении во время диалога?
Задача 9
Разработчик добавил инструмент check_schedule(date, time) в конфигурацию LLM-агента. Что теперь может делать агент, чего не мог без инструмента?
Задача 10
Сопоставьте компонент пайплайна с типичным диапазоном задержки.
Сопоставьте элементы
Продолжить с сохранением прогресса
Перейдите к уроку в учебном кабинете.

