
Урок курса
VAD и end-of-turn: как агент слышит и понимает конец фразы
Voice AI Agents PROVAD: два подхода к определению границ речи
В предыдущих уроках VAD (Voice Activity Detector) появлялся как один из параметров STT-сессии: пауза дольше порогового значения — реплика завершена. Но за этим описанием скрыто важное инженерное решение: какой алгоритм стоит за детектором? Именно алгоритм определяет, насколько агент устойчив к фоновому шуму — а значит, как он ведёт себя в условиях реального телефонного звонка.
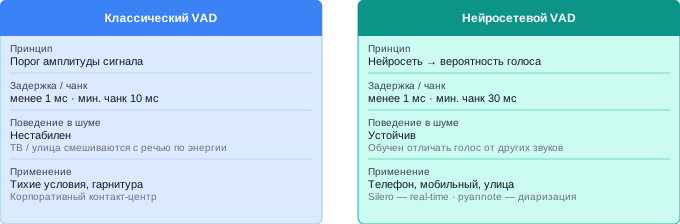
Классический VAD
Классические VAD-алгоритмы работают по явно заданным правилам: анализируют уровень энергии и частотный профиль чанка, затем классифицируют его через статистическую модель. Типичная реализация — WebRTC VAD от Google: каждые 10–30 мс алгоритм извлекает частотные признаки и классифицирует их через GMM (Gaussian Mixture Model) как «речь» или «тишина». Поддерживаются частоты 8000, 16000, 32000 и 48000 Гц, четыре уровня агрессивности (0–3). Один чанк обрабатывается менее чем за 1 мс.
Главное ограничение — шум обманывает классификатор. GMM обучен на относительно чистых данных и не умеет надёжно отличить голос от телевизора в соседней комнате, уличного трафика или разговоров рядом. Результат: VAD либо постоянно «открыт» и принимает шум за речь, либо порог поднят так высоко, что обрезаются тихие фрагменты реплики.
Нейросетевой VAD
Нейросетевые VAD-модели не опираются на явные признаки — они обучены напрямую распознавать человеческую речь на данных с фоновым шумом, музыкой, акцентами и материалами на тысячах языков. Вместо бинарной метки такая модель возвращает вероятность присутствия голоса в чанке, что позволяет точнее работать с граничными случаями.
Silero VAD — наиболее распространённая реализация для real-time задач: модель весом около 2 МБ обрабатывает чанки от 30 мс при 8 или 16 кГц менее чем за 1 мс на одном потоке CPU. Накладные расходы сопоставимы с WebRTC VAD, устойчивость к шуму — значительно выше. pyannote/segmentation — более тяжёлая альтернатива с точными временными метками и встроенной диаризацией (определение, кто говорит); используется в офлайн-пайплайнах транскрипции, где важна атрибуция говорящего, а не только граница реплики.
Для телефонных и мобильных звонков в реальном времени — нейросетевой VAD, на практике чаще всего Silero. WebRTC VAD достаточен там, где сигнал контролируем: корпоративный контакт-центр с гарнитурой в 2 см от губ без фонового шума. pyannote — выбор офлайн-транскрипции с несколькими говорящими.
End-of-turn: семантический детектор
Тишина — акустическая метрика, а конец реплики — семантический признак. Классический VAD не различает паузу между репликами и паузу внутри фразы: когда клиент медленно перечисляет, или задумался подбирая слово — хезитирует — VAD с коротким таймаутом уже считает, что реплика завершена. Увеличить таймаут паузы не помогает: это сдвигает границу ошибки, но не убирает её.
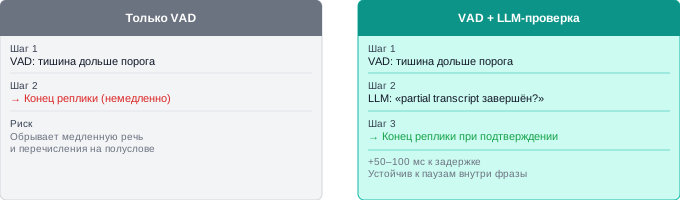
Идея: два условия вместо одного
Семантический детектор добавляет второй слой поверх VAD. Агент начинает отвечать только тогда, когда выполнены оба условия: VAD зафиксировал тишину и классификатор подтвердил, что фраза семантически завершена. Если VAD сработал, но классификатор вернул «незавершено» — агент продолжает ждать, даже если пауза уже длиннее порогового значения.
Это позволяет выставить таймаут паузы VAD в 200–300 мс — агрессивные значения, при которых агент без семантического слоя постоянно обрывал бы клиентов на полуслове. Нормальный диапазон без семантики — 400–600 мс; с семантическим слоем можно работать вдвое быстрее, потому что ложные срабатывания VAD отфильтровываются на следующем шаге. Задержка ответа при этом не растёт: большинство коротких пауз действительно означают конец реплики, и агент реагирует на них быстрее обычного.
Что делает классификатор
Классификатор получает накопленный транскрипт и отвечает на один вопрос: реплика завершена? Самый простой способ понять механику — реализовать его вызовом языковой модели:
SYSTEM = (
    "Determine if the user has finished speaking. "
    "Reply with exactly one word: complete or incomplete."
)

async def is_turn_complete(transcript: str) -> bool:
    response = await llm.chat.completions.create(
        model="gpt-5.4-nano",
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": transcript},
        ],
        max_tokens=1,
        temperature=0,
    )
    return response.choices[0].message.content.strip().lower() == "complete"
На практике вызов общего LLM для каждого срабатывания VAD — слишком медленно и дорого. Поэтому в реальных пайплайнах используют не общий LLM, а специализированный маленький трансформер, обученный ровно на эту задачу: определить конец высказывания по тексту и контексту разговора. Такие модели работают за 20–30 мс против 100–300 мс у LLM-запроса, весят около 400 МБ и запускаются локально на том же сервере, что и пайплайн.
Параметр неуверенности
Классификатор возвращает не бинарное «завершено / не завершено», а вещественное число от 0 до 1 — вероятность того, что реплика ещё не закончена. Порог задаётся явно: если вероятность незавершённости ниже порога — агент отвечает, если выше — ждёт продолжения.
Хорошо обученный классификатор на большинстве реплик уверен: он возвращает значения, близкие к 0 (явно закончено) или к 1 (явно не закончено). Неопределённость в промежутке 0.05–0.4 возникает редко — это случаи хезитации, незаконченных вопросов, перечислений с паузами. Именно там выбор порога имеет значение.
На практике рабочий диапазон — от 0.02 до 0.15:
- Ниже 0.02 — семантический слой почти ничего не фильтрует: агент реагирует при любом намёке на тишину, практически как обычный VAD.
- 0.02–0.05 — быстрый режим: редкие ложные срабатывания остаются, но их заметно меньше, чем без классификатора. Подходит для коротких диалогов с однозначными репликами.
- 0.05–0.10 — основной рабочий диапазон: агент ждёт, если модель хотя бы немного не уверена, и при этом не добавляет заметной задержки на явно завершённых фразах.
- 0.10–0.15 — консервативный режим: агент ощутимо выдерживает паузу даже на коротких однозначных ответах, зато хезитации практически не прерывает.
- Выше 0.15 — агент начинает подвисать даже на «да» и «нет»: модель недостаточно уверена в коротких репликах, чтобы уложиться в порог.
Значение около 0.03 — типичный ориентир для первого запуска: это точка, где классификатор должен быть уверен на 97%, что реплика завершена, прежде чем агент ответит. На практике большинство реплик классификатор оценивает с уверенностью 99%+, поэтому задержки почти нет. Если после запуска появляются жалобы на прерывания — поднимайте значение с шагом 0.02, пока не исчезнут.
Когда семантика не нужна
Добавлять второй слой имеет смысл не всегда. Если сценарий состоит из коротких однозначных команд — «да», «нет», назвать цифру — реплика всегда заканчивается без пауз, и настроенного порога тишины достаточно. Семантический детектор даёт преимущество там, где клиент говорит свободно: диктует данные, рассказывает о проблеме, перечисляет пожелания.
Параметры провайдеров и Silero VAD в коде
В уроках по SpeechKit и SaluteSpeech параметр длины паузы упоминался с одним значением. Здесь разберём, что именно он контролирует, как выбирать значение под задачу, и как подключить Silero VAD в собственный пайплайн.
Yandex SpeechKit: EouClassifier
Параметр max_pause_between_words_hint_ms передаётся через EouClassifierOptions — отдельный объект в StreamingOptions, который стоит рядом с RecognitionModelOptions, а не внутри него:
stt_pb2.StreamingOptions(
    recognition_model=stt_pb2.RecognitionModelOptions(...),
    eou_classifier=stt_pb2.EouClassifierOptions(
        default_classifier=stt_pb2.DefaultEouClassifier(
            max_pause_between_words_hint_ms=500,
        )
    ),
)
Слово «hint» в названии точное: это подсказка детектору конца реплики, а не жёсткий таймаут. SpeechKit учитывает её вместе с акустическими и языковыми признаками. Ориентиры для выбора значения:
- 400–600 мс — голосовой агент, где важна скорость реакции
- 600–800 мс — телефонная линия, клиенты говорят медленнее
- 800–1200 мс — пожилые клиенты или сценарии с диктовкой
SaluteSpeech: eou_timeout
В RecognitionOptions SaluteSpeech параметр eou_timeout передаётся через вложенное сообщение Hints. Тип поля — google.protobuf.Duration:
from google.protobuf.duration_pb2 import Duration

recognition_pb2.RecognitionOptions(
    language="ru-RU",
    audio_encoding=recognition_pb2.RecognitionOptions.PCM_S16LE,
    sample_rate=16000,
    channels_count=1,
    hints=recognition_pb2.Hints(
        eou_timeout=Duration(seconds=1),   # ждать 1 секунду тишины после последнего слова
    ),
)
Флаг eou=True в ответе появляется после того, как истёк этот таймаут — в этот момент results[0].normalized_text возвращает финальный текст. Уменьшите значение, если агент реагирует слишком медленно; увеличьте, если часто обрывает клиентов на полуслове.
Точный синтаксис поля зависит от версии proto-схемы SaluteSpeech. Сверьтесь с текущим
recognition.protoиз репозиторияsalute-developers/salute-speechперед использованием.
Deepgram: endpointing
В Deepgram параметр передаётся в URL WebSocket-соединения как число миллисекунд:
ws_url = (
    "wss://api.deepgram.com/v1/listen"
    "?model=nova-3"
    "&language=ru"
    "&endpointing=500"        # 500 мс тишины = конец реплики
    "&interim_results=true"
)
Когда endpoint обнаружен, в ответе приходит "speech_final": true — именно это поле сигнализирует о конце реплики, а не просто о финализации partial transcript. Отключить поведение: endpointing=false.
Silero VAD: подключение к пайплайну
pip install silero-vadДля стримингового пайплайна используется VADIterator — stateful-обёртка, которая накапливает чанки и возвращает события начала и конца речи:
import torch
from silero_vad import load_silero_vad, VADIterator

SAMPLE_RATE = 16000

model = load_silero_vad()
vad = VADIterator(
    model,
    threshold=0.5,                # вероятность речи, выше которой — речь
    sampling_rate=SAMPLE_RATE,
    min_silence_duration_ms=500,  # пауза для фиксации конца реплики
    speech_pad_ms=100,            # паддинг вокруг сегмента речи
)


def on_audio_chunk(pcm_bytes: bytes) -> dict | None:
    """Принимает PCM 16-бит 16 кГц, возвращает событие VAD или None."""
    tensor = torch.frombuffer(pcm_bytes, dtype=torch.int16).float() / 32768.0
    return vad(tensor, return_seconds=True)
    # Возвращает {"start": 1.23} | {"end": 2.45} | None
Событие {"end": ...} — момент окончания реплики; это сигнал передавать накопленный аудиобуфер в STT. Событие {"start": ...} — начало речи; используется для отмены воспроизводимого TTS при barge-in.
Отладка VAD: что логировать и как диагностировать
VAD-проблемы в продакшне редко видны в агрегированных метриках — пока клиент не начнёт жаловаться или пока не появится запись, где агент обрывает каждую третью фразу. Правильно выстроенное логирование позволяет увидеть проблему раньше.
Что логировать
Минимальный набор событий для каждого VAD-сегмента:
vad_start— unix-timestamp начала речи, ID звонкаvad_end— timestamp конца речи, длительность сегментаsegment_duration_ms— вычисляется какvad_end – vad_startconfidence— вероятность речи от Silero VAD (если используется Silero)transcript_words— количество слов в финальном транскрипте сегмента
Три диагностических паттерна
Много коротких сегментов без транскрипта (< 300 мс, 0–1 слово). VAD видит фоновый шум как речь. Либо порог срабатывания слишком низкий, либо используется WebRTC VAD в шумных условиях. Решение: переключиться на Silero VAD или повысить threshold до 0.6–0.7.
Транскрипт обрывается в середине предложения. Финальный транскрипт семантически незавершён — нет глагола, прерванное перечисление, оборванный вопрос. Признак агрессивного порога паузы. Увеличьте min_silence_duration_ms или max_pause_between_words_hint_ms на 100–200 мс и сравните долю оборванных реплик.
Сегменты длиннее 15–20 секунд без финализации. VAD не видит конца реплики: клиент говорит непрерывно или порог слишком высокий. Добавьте жёсткий таймаут: если сегмент длиннее max_segment_ms, форсировать EOU и передать накопленный текст в LLM как есть.
Задача 1
Сопоставьте каждый инструмент с его описанием.
Сопоставьте элементы
Задача 2
В каком из перечисленных сценариев классического WebRTC VAD достаточно без нейросетевой замены?
Задача 3
Какие из утверждений про Silero VAD верны? Выберите все подходящие.
Задача 4
Какой таймаут паузы VAD можно безопасно использовать вместе с семантическим детектором конца реплики?
Задача 5
Что именно возвращает семантический классификатор end-of-turn?
Задача 6
Какое значение параметра неуверенности классификатора рекомендуется как ориентир для первого запуска?
Задача 7
Сопоставьте провайдер или инструмент с параметром, задающим конец реплики.
Сопоставьте элементы
Задача 8
Как в ответе Deepgram WebSocket API обозначается конец реплики?
Задача 9
Какое из событий VADIterator является сигналом для передачи аудиобуфера в STT?
Задача 10
В логах вы видите много VAD-сегментов длительностью до 300 мс с пустым или однословным транскриптом. О чём это говорит?
Продолжить с сохранением прогресса
Перейдите к уроку в учебном кабинете.

