
Урок курса
OpenAI Realtime API: speech-to-speech
Voice AI Agents PRORealtime-модель: speech-to-speech без промежуточного текста
В первом модуле вы разбирали две архитектуры голосового агента: каскад STT → LLM → TTS из трёх отдельных сервисов и нативный realtime, где одна модель принимает аудиопоток и сразу отдаёт аудио в ответ. Каскад вы уже собирали — на российском стеке и во фреймворках. Этот модуль — про второй путь: realtime-модели как отдельный класс, их протоколы и встраивание в код.
Начнём с OpenAI Realtime — самой проработанной realtime-платформы на рынке. На ней удобно разобрать механику, которая дальше повторяется у других провайдеров: сессия, события, вызов инструментов. Затем посмотрим на зарубежных конкурентов, российский realtime от Яндекса и то, как всё это подключается в Pipecat и LiveKit.
Что меняет realtime
Слабое место каскада вы уже видели на практике: задержки распознавания, ответа и синтеза складываются, и пауза перед репликой агента растёт. Realtime убирает промежуточный текст — аудио входит в одну модель, и она сразу отдаёт аудио в ответ. Синтез идёт потоком: речь начинает звучать ещё до того, как модель закончила формулировать ответ целиком. За счёт этого задержка держится в пределах примерно секунды, а перебивание (barge-in) встроено в саму модель.
Расплата — меньше контроля над компонентами: распознавание и синтез выполняет сама модель провайдера, и выбор голоса ограничен тем, что он предлагает.
Три транспорта: как звук идёт к модели и обратно
OpenAI Realtime не привязан к одному способу передачи аудио. Соединение с моделью устанавливается одним из трёх транспортов, и выбор зависит от того, откуда приходит звук. Соединение всегда двустороннее: аудио клиента уходит в модель, а тем же каналом возвращается ответ — аудиопоток с синтезированной речью и параллельно служебные события (распознанный текст, вызовы инструментов). То есть на выходе из модели снова аудио, а не текст, который вам пришлось бы озвучивать самим.
WebRTC (Web Real-Time Communication — браузерный стандарт передачи аудио и видео в реальном времени) — для браузера и мобильных приложений. Он сам решает задачи передачи звука по нестабильной сети: буферизацию, потерю пакетов, эхо. Когда агент работает прямо на странице сайта или в приложении, это транспорт по умолчанию.
WebSocket (постоянное двустороннее соединение поверх одного TCP-канала: в отличие от обычных HTTP-запросов канал держат открытым, и данные идут в обе стороны без переподключения) — для серверной интеграции. Бэкенд получает сырой аудиопоток откуда-то — от телефонии, из медиапайплайна — и сам передаёт его в модель по этому соединению. Это основной транспорт, когда realtime-агент работает на сервере, а не в клиенте.
SIP (Session Initiation Protocol — протокол установки и управления звонками в IP-телефонии) — для телефонии. Через SIP-мост входящий или исходящий звонок с обычного номера подключается к realtime-сессии напрямую, без отдельного слоя распознавания на вашей стороне.
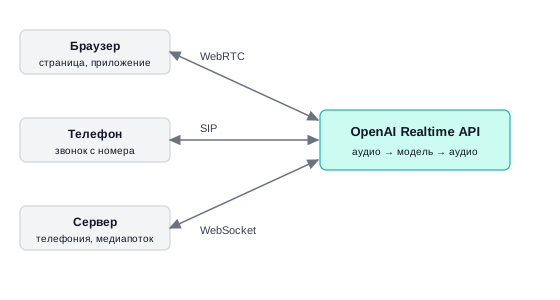
Практическое правило простое: звук из браузера — WebRTC, звук с телефонного номера — SIP, звук, который уже пришёл к вам на сервер, — WebSocket. В этом модуле мы работаем в основном с WebSocket как с самым универсальным случаем для серверного агента.
Сессия и события OpenAI Realtime
Когда транспорт установил соединение, начинается сессия. Внутри неё нет привычных пар «запрос — ответ»: общение идёт потоком событий. Каждое событие — сообщение с типом, по которому понятно, что это и как его обрабатывать. Клиент шлёт события серверу, сервер отвечает своими.
Жизненный цикл сессии
Сессия создаётся в момент подключения. Первое, что присылает сервер, — событие session.created с текущей конфигурацией по умолчанию. Дальше клиент может в любой момент поменять настройки событием session.update, не разрывая соединение: сменить системный промпт, набор модальностей или список инструментов. Голос — исключение: его можно задать только до того, как модель впервые ответит аудио, а саму модель в середине сессии сменить нельзя вовсе.
Аудио клиент отправляет фрагментами во входной буфер. Когда нужно, чтобы модель ответила, клиент шлёт response.create — именно в этом событии передаются инструкции и доступные инструменты для конкретного ответа. Сервер отвечает серией событий: response.created на старте, затем поток фрагментов ответа по мере генерации, и response.done, когда ответ закончен. Поскольку результат приходит потоком, воспроизведение начинается сразу, не дожидаясь полного ответа.
Сессия хранит историю диалога и конфигурацию. Бизнес-состояние — что клиент заказал, какая запись создана — в сессии не лежит: его держит само приложение.
Barge-in здесь работает на уровне сессии. Если клиент заговорил, пока агент ещё отвечает, поступает событие о начале речи, и приложение останавливает воспроизведение текущего ответа. Отдельный детектор конца реплики писать не нужно — модель определяет границы речи сама.
Как это выглядит в коде
Серверный агент подключается к модели по транспорту WebSocket. Официальный SDK (pip install openai) берёт сокет на себя: client.realtime.connect() открывает соединение, а события сессии отправляются типизированными методами вместо ручной сборки JSON. Ниже — минимальный цикл одной сессии: настройка, отправка аудио и чтение потока ответных событий. Ходом разговора здесь управляем вручную; если включить определение границ речи (VAD), сервер сам закрывает входной буфер и запускает ответ.
import asyncio
import base64

from openai import AsyncOpenAI

client = AsyncOpenAI()  # ключ берётся из переменной окружения OPENAI_API_KEY


async def main() -> None:
    async with client.realtime.connect(model="gpt-realtime-2") as conn:
        # Настраиваем сессию, не разрывая соединение
        await conn.session.update(session={
            "type": "realtime",
            "instructions": "Ты — оператор поддержки магазина. Отвечай кратко.",
            "output_modalities": ["audio"],
            "audio": {
                "input": {"format": {"type": "audio/pcm", "rate": 24000}},
                "output": {"voice": "marin"},
            },
        })

        # Отправляем аудио клиента фрагментами во входной буфер (PCM16, 24 кГц)
        for chunk in read_pcm_chunks("question.pcm"):
            await conn.input_audio_buffer.append(audio=base64.b64encode(chunk).decode())

        # Просим модель ответить на накопленный буфер
        await conn.input_audio_buffer.commit()
        await conn.response.create()

        # Ответ приходит потоком событий — воспроизводим речь по мере поступления
        async for event in conn:
            if event.type == "response.output_audio.delta":
                play(base64.b64decode(event.delta))
            elif event.type == "response.done":
                break


asyncio.run(main())
Каждый вызов метода — это событие сессии: conn.session.update(), conn.input_audio_buffer.append(), conn.response.create(). Ответные события приходят объектами с полем type: response.output_audio.delta несёт очередной фрагмент речи, response.done закрывает ответ. Функции read_pcm_chunks и play — заглушки источника аудио и вывода звука, их реализует само приложение.
Так выходит, потому что официальный SDK отвечает за канал с моделью, а не за звуковое устройство. Он держит соединение и события сессии: на вход ждёт готовые байты PCM16, на выход отдаёт такие же байты в response.output_audio.delta. Захват с микрофона и воспроизведение в динамик зависят от среды — десктоп, сервер, телефонный канал, — поэтому остаются на стороне приложения. В Python их обычно берут на себя библиотеки вроде sounddevice или pyaudio, а в телефонии источником и приёмником звука служит медиапоток звонка. Высокоуровневые фреймворки закрывают этот слой сами, и тогда read_pcm_chunks с play писать уже не нужно; обёртки над realtime-сессией разбираются в следующих уроках модуля.
GPT-Realtime-2 и уровень рассуждений
Основная голосовая модель OpenAI на сегодня — GPT-Realtime-2. Её отличает интеллект уровня GPT-5: она лучше следует инструкциям и надёжнее вызывает инструменты в сложных сценариях. Новое по сравнению с ранними realtime-моделями — настраиваемый уровень рассуждений reasoning.effort.
Параметр задаёт, насколько глубоко модель обрабатывает запрос перед ответом. Чем выше уровень, тем точнее ответ в сложных случаях, но и тем дольше пауза перед речью — на высоких уровнях молчание становится заметным. Для живого диалога это критично: клиент не должен ждать. Поэтому для большинства голосовых агентов начинают с уровня low и повышают только там, где задача действительно требует более сложного рассуждения.
Вызов инструментов в realtime-сессии
Голосовой агент почти всегда должен что-то делать с внешним миром: проверить статус заказа, найти свободное окно в расписании, создать заявку. В OpenAI Realtime это устроено через вызов функций (function calling) — тот же механизм, что у обычных моделей, но встроенный в поток событий сессии.
Как объявляются инструменты
Список доступных инструментов передаётся в конфигурации сессии или конкретного ответа. Каждый инструмент описывается именем, текстовым пояснением и схемой параметров — по этому описанию модель определяет, когда и с какими аргументами его вызывать.
{
  "type": "function",
  "name": "get_order_status",
  "description": "Вернуть статус заказа по его номеру",
  "parameters": {
    "type": "object",
    "properties": {
      "order_id": { "type": "string", "description": "Номер заказа из четырёх цифр" }
    },
    "required": ["order_id"]
  }
}
Что происходит во время вызова
Когда по ходу разговора инструмент нужен, модель не озвучивает выдуманный ответ, а включает в свой ответ элемент с вызовом функции: имя и аргументы. Приложение видит этот элемент, выполняет настоящую функцию у себя — обращается к базе, к CRM, к API — и отправляет результат обратно в сессию отдельным событием. После этого модель продолжает реплику уже с реальными данными.
Аудиопоток при этом не разрывается: пока приложение выполняет функцию, соединение остаётся живым, и клиент продолжает разговор. Результат вызова добавляется в историю диалога, поэтому в следующих репликах модель опирается на уже полученные данные.
GPT-Realtime-2 умеет запрашивать несколько инструментов сразу — параллельные вызовы. Если для ответа нужно и проверить заказ, и уточнить адрес пункта выдачи, модель может затребовать обе функции в одном ответе, а приложение выполнит их вместе и вернёт оба результата. Это сокращает число кругов «вопрос — вызов — ответ» и держит задержку низкой.
Цикл вызова в коде
В коде это разворачивается в один обработчик событий. Инструмент из примера выше передаётся в конфигурацию сессии, а дальше приложение ждёт события response.function_call_arguments.done — в нём приходят имя функции, её аргументы и идентификатор вызова call_id.
import base64
import json

ORDERS = {"1042": "собран, передан в доставку", "1043": "оплачен, собирается на складе"}


def get_order_status(order_id: str) -> str:
    return ORDERS.get(order_id, "заказ с таким номером не найден")


async def run(conn, tool: dict) -> None:
    # Объявляем инструмент в конфигурации сессии (tool — словарь из примера выше)
    await conn.session.update(session={"type": "realtime", "tools": [tool], "tool_choice": "auto"})

    async for event in conn:
        if event.type == "response.function_call_arguments.done":
            # Модель запросила вызов: выполняем настоящую функцию у себя
            args = json.loads(event.arguments)
            result = get_order_status(args["order_id"])

            # Возвращаем результат в сессию отдельным элементом диалога
            await conn.conversation.item.create(item={
                "type": "function_call_output",
                "call_id": event.call_id,
                "output": json.dumps({"status": result}, ensure_ascii=False),
            })
            # Просим модель продолжить реплику уже с реальными данными
            await conn.response.create()

        elif event.type == "response.output_audio.delta":
            play(base64.b64decode(event.delta))
Результат уходит в сессию вызовом conn.conversation.item.create() с типом function_call_output и тем же call_id, а следующий conn.response.create() запускает продолжение реплики. При параллельных вызовах сервер пришлёт несколько событий response.function_call_arguments.done подряд — приложение отвечает на каждый своим function_call_output, прежде чем запросить ответ.
Здесь мы намеренно работаем с сырым протоколом: сами описываем схему инструмента, сами разбираем событие вызова и сами возвращаем результат. SDK от OpenAI даёт транспорт и события сессии, но не превращает обычную Python-функцию в инструмент автоматически — описание и цикл вызова остаются на приложении. Такой уровень полезно увидеть один раз, чтобы понимать, что происходит под капотом. На реальном проекте поверх этого обычно ставят фреймворк: он генерирует схему инструмента из самой функции и берёт цикл вызова на себя. Какой именно фреймворк выбрать — решает разработчик; обёртки над realtime-сессией разбираются в следующих уроках модуля.
Кроме ручного описания функций, Realtime поддерживает подключение инструментов через MCP — внешний сервер публикует набор инструментов, и они становятся доступны агенту целиком. Разница в том, кто их исполняет: обычную функцию вызывает ваше приложение, а MCP-инструменты Realtime API выполняет на своей стороне. Это удобно, когда одни и те же инструменты переиспользуются между агентами.
Семейство realtime-моделей OpenAI
«Realtime» у OpenAI — это не одна модель, а несколько, заточенных под разные задачи голосового потока. Под голосового агента, живой перевод и стриминговое распознавание берут разные модели, и подключаются они через тот же протокол сессии и событий.
GPT-Realtime-2 — голосовой агент
Основная модель для диалоговых агентов: принимает речь, отвечает речью, вызывает инструменты, держит контекст разговора. Это её вы используете, когда нужен собеседник — поддержка, запись на приём, продажи. Настраиваемый уровень рассуждений позволяет балансировать между скоростью ответа и глубиной обработки сложных запросов.
GPT-Realtime-Translate — живой перевод
Отдельная модель для синхронного перевода речи: человек говорит на одном языке, на выходе сразу звучит другой. Поддерживает более 70 языков на входе. Это не диалоговый агент — модель не ведёт разговор и не вызывает инструменты, её задача — переводить поток речи с минимальной задержкой. Подходит для звонков между собеседниками на разных языках и для перевода в реальном времени.
GPT-Realtime-Whisper — стриминговое распознавание
Модель только для перевода речи в текст в реальном времени — без генерации ответа и без синтеза. Нужна там, где требуется именно расшифровка потока: субтитры, транскрипт звонка, передача текста в отдельную логику. По сути это потоковый STT — отдельная модель под стриминговое распознавание, с самой низкой задержкой среди вариантов транскрипции.
Что сколько стоит
Оплата у голосовой модели идёт по аудио-токенам, а не по фиксированной минуте: отдельно входящие и исходящие токены, плюс дешёвые кэшированные токены для повторно используемой информации вроде системного промпта. У GPT-Realtime-Translate и GPT-Realtime-Whisper тариф проще — за минуту потока. Порядок цен: перевод — около 0,034 долл. за минуту, распознавание — около 0,017 долл. за минуту.
Конкретные тарифы и идентификаторы версий моделей меняются — перед внедрением сверяйтесь с актуальным прайс-листом и документацией OpenAI, а не с цифрами из урока.
Выбор модели сводится к задаче потока: нужен собеседник с инструментами — GPT-Realtime-2; нужно переводить речь между языками — GPT-Realtime-Translate; нужен только текст из речи — GPT-Realtime-Whisper.
Задача 1
Что отличает нативную realtime-модель от каскада STT → LLM → TTS? Выберите все верные утверждения.
Задача 2
Какие утверждения о транспортах OpenAI Realtime верны? Выберите все подходящие.
Задача 3
За счёт чего нативная realtime-модель держит задержку около секунды там, где каскад её накапливает?
Задача 4
Что в уже идущей сессии OpenAI Realtime изменить нельзя?
Задача 5
Расположите события одного ответа OpenAI Realtime в порядке, в котором они проходят за реплику — от запроса ответа до его завершения.
Расположите элементы в правильном порядке
- 1.Сервер присылает response.done
- 2.Идёт поток response.output_audio.delta
- 3.Сервер присылает response.created
- 4.Клиент отправляет response.create
Задача 6
Сопоставьте событие сессии OpenAI Realtime с тем, что оно делает.
Сопоставьте элементы
Задача 7
Модель в realtime-сессии запросила вызов функции. Что приложение возвращает в сессию, чтобы модель продолжила реплику с реальными данными?
Задача 8
Что верно о вызове инструментов в GPT-Realtime-2? Выберите все подходящие утверждения.
Задача 9
Почему GPT-Realtime-Translate не подходит на роль голосового агента поддержки?
Задача 10
Чем тарификация GPT-Realtime-2 отличается от GPT-Realtime-Translate и GPT-Realtime-Whisper?
Продолжить с сохранением прогресса
Перейдите к уроку в учебном кабинете.

