
Урок курса
LiveKit Agents: голосовой агент на фреймворке
Voice AI Agents PROАрхитектура LiveKit Agents
LiveKit Agents — второй крупный фреймворк голосовых агентов, Python-пакет livekit-agents. Задачу он решает ту же, что и Pipecat, но подход противоположный: вместо конструктора из мелких деталей — готовый оркестратор поверх собственной медиаинфраструктуры. Внутри пакета три части, которые стоит различать с самого начала: оркестратор, плагины и медиасервер.
AgentSession — оркестратор
Центральный объект фреймворка — AgentSession. Это и есть тот слой координации, который в Pipecat вы собирали из процессоров, — здесь он приходит готовым. Когда вы передаёте ему компоненты — определение голоса, распознавание, модель, синтез, — он запускает событийный цикл, ловит конец реплики, обрывает свою речь при перебивании и стыкует потоки между распознаванием, моделью и синтезом. Вы конфигурируете сессию один раз, дальше разговор она ведёт сама.
Важно про версии. До версии 1.0 (апрель 2025) в фреймворке было два разных класса:
VoicePipelineAgentдля каскада STT → LLM → TTS иMultimodalAgentдля realtime-моделей. В 1.0 их объединили в единыйAgentSession. Сейчас актуальна ветка 1.x. Примеры из старых статей и туториалов часто всё ещё показываютVoicePipelineAgent— это устаревший код, в новых проектах его не используют.
Плагины — сменные компоненты
Сами распознавание, модель и синтез фреймворк не реализует. Он подключает их через плагины — обёртки над провайдерами с единым интерфейсом. Плагин Deepgram даёт распознавание, плагин OpenAI — модель, плагин Cartesia — синтез, плагин Silero — определение голоса. Для AgentSession они взаимозаменяемы: захотели сменить провайдера синтеза — поменяли одну строку, остальной код не трогаете.
Плагины ставятся как extras — необязательные дополнения пакета в квадратных скобках. Вы перечисляете только то, что нужно вашему агенту:
pip install "livekit-agents[openai,silero,deepgram,cartesia,turn-detector]"Здесь openai — плагин модели, deepgram — распознавание, cartesia — синтез, silero — определение голоса, turn-detector — детектор конца реплики. Список можно собрать под свой стек; провайдеры выбираются по задаче из тех, что разбирались ранее.
Готовых плагинов под российские сервисы — Yandex SpeechKit, SaluteSpeech, YandexGPT, GigaChat — в LiveKit нет. Подключить их можно, но только своей обёрткой поверх базовых классов плагина — для российского контура это главный практический нюанс LiveKit.
WebRTC-медиасервер — транспорт
Третья часть — собственный WebRTC-медиасервер LiveKit. По типу это SFU (Selective Forwarding Unit): сервер, который получает звуковые дорожки всех участников и раздаёт их остальным, не смешивая в один поток. Это тот самый транспортный слой — он принимает звук от человека, доставляет его агенту и отдаёт назад синтезированную речь, держа задержку низкой и переживая потери пакетов в сети. У LiveKit медиасервер встроен в платформу — отдельно поднимать канал связи не нужно, тогда как в Pipecat транспорт вы выбирали сами крайними процессорами пайплайна.
В коде агент работает внутри «комнаты» (room) на этом сервере: человек и агент — два участника одной комнаты, обменивающиеся звуковыми дорожками. Сам медиасервер можно запускать в облаке LiveKit или развернуть у себя — фреймворк и сервер открытые.
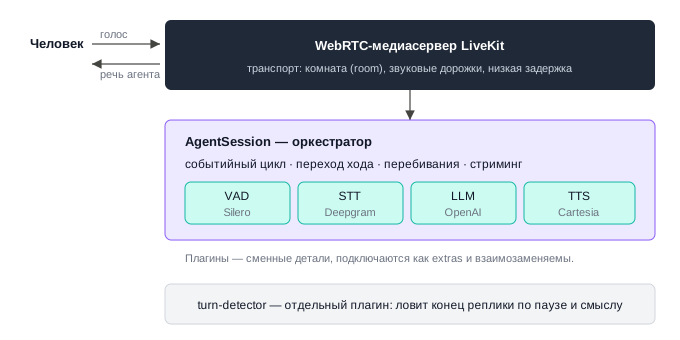
Получается три слоя ответственности. Плагины — это сменные детали, которые вы выбираете. AgentSession — оркестратор, который ими дирижирует. Медиасервер — канал, по которому идёт звук. Вместе они закрывают всё, что без фреймворка пришлось бы держать руками.
Минимальный агент: код
Соберём работающего голосового агента. Кода немного, потому что вся координация спрятана в AgentSession, — наша задача только выбрать компоненты и описать поведение агента.
Точка входа
Агент LiveKit живёт внутри функции-точки входа entrypoint. Её регистрируют на сервере агента: создаём AgentServer и вешаем декоратор @server.rtc_session() — фреймворк сам вызовет функцию, когда появится работа (например, в комнату пришёл человек), и сам поднимет соединение с медиасервером. На вход приходит JobContext — контекст задания: через ctx.room агент получает доступ к комнате.
from livekit import agents
from livekit.agents import Agent, AgentServer, AgentSession, TurnHandlingOptions
from livekit.plugins import openai, deepgram, cartesia, silero
from livekit.plugins.turn_detector.multilingual import MultilingualModel


server = AgentServer()


@server.rtc_session()
async def entrypoint(ctx: agents.JobContext):
    session = AgentSession(
        vad=silero.VAD.load(),
        stt=deepgram.STT(model="nova-3", language="multi"),
        llm=openai.LLM(model="gpt-5.4-mini"),
        tts=cartesia.TTS(),
        turn_handling=TurnHandlingOptions(turn_detection=MultilingualModel()),
    )

    await session.start(
        room=ctx.room,
        agent=Agent(
            instructions=(
                "Ты — голосовой администратор клиники. Отвечай одной "
                "короткой фразой, без восклицаний. Перед проверкой "
                "расписания скажи «секунду, смотрю»."
            )
        ),
    )


if __name__ == "__main__":
    agents.cli.run_app(server)
Это полный рабочий агент. Разберём по частям.
AgentSession: выбор компонентов
В конструктор AgentSession передаются те самые плагины. Каждый параметр — отдельный слой пайплайна:
vad— определение голоса, локальная модель Silero;stt— распознавание речи, потоковый Deepgram Nova-3 в мультиязычном режиме (language="multi"), он держит русскую речь;llm— модель, здесьgpt-5.4-mini: для голоса важна низкая задержка, а лёгкая модель отвечает быстрее тяжёлой;tts— синтез речи, Cartesia;turn_handling— детектор конца реплики, обёрнутый вTurnHandlingOptions.
Захотите более сильную модель на сложные диалоги — поставите gpt-5.5; нужен российский контур — туда же пойдёт обёртка над YandexGPT или GigaChat. То же и с распознаванием: для англоязычных агентов у Deepgram есть более новая «разговорная» модель Flux (класс deepgram.STTv2), которая сама ловит конец реплики, — но русского она пока не знает, поэтому здесь оставляем мультиязычный Nova-3. Структура кода от замен не меняется: AgentSession работает с любым плагином через единый интерфейс.
Локальные замены: без платных ключей
Если хочется обойтись без внешних API — разработка офлайн, прощупать архитектуру без расходов — оба ключевых слоя меняются на локальные варианты буквально за несколько строк.
LLM → LM Studio. LM Studio запускает локальную модель (Llama, Mistral, Qwen и другие) и поднимает OpenAI-совместимый сервер на http://localhost:1234/v1. Никакого нового плагина не нужно — тот же openai.LLM, просто с другим адресом:
llm=openai.LLM(
    model="lmstudio-community/Llama-3.2-3B-Instruct-GGUF",
    base_url="http://localhost:1234/v1",
    api_key="lm-studio",  # произвольное значение, LM Studio его игнорирует
),
STT → локальный Whisper. faster-whisper или whisper.cpp можно запустить с OpenAI-совместимым HTTP-интерфейсом — и тот же плагин openai.STT перенаправится туда:
stt=openai.STT(
    model="whisper-1",
    base_url="http://localhost:8000/v1",
    api_key="no-key",
),
TTS. Готового плагина для офлайн-синтеза в LiveKit пока нет. Подключить можно любой сервис, который принимает текст и отдаёт аудио, — для этого пишется кастомный плагин на базе класса tts.TTS. Как это делается, разобрано в уроке «LiveKit: обёртки для российского стека» на примере Yandex SpeechKit — принцип одинаков для любого HTTP-сервиса синтеза.
API-ключи
В коде нет ни одного ключа — каждый плагин читает его из переменной окружения. Для трёх платных сервисов нужны OPENAI_API_KEY, DEEPGRAM_API_KEY и CARTESIA_API_KEY. Плагин silero использует локальную модель, ключ ему не нужен.
Зачем вообще нужен LiveKit — и почему три отдельных ключа
Deepgram, OpenAI и Cartesia — это AI-провайдеры: они делают «мозговую» работу (распознавание, генерацию, синтез). LiveKit — другой слой: это медиаинфраструктура. Именно LiveKit создаёт «комнату», в которой встречаются пользователь и агент, маршрутизирует аудиопоток по WebRTC и держит соединение в реальном времени.
Без запущенного LiveKit-сервера агенту просто некуда подключаться — нет ни комнаты, ни аудиоканала. В коде это видно: @server.rtc_session() и ctx.room — это работа с LiveKit, а не с Deepgram или OpenAI. Само соединение с медиасервером фреймворк поднимает за нас, когда вызывает entrypoint.
LiveKit — open-source проект, его можно поднять на своём сервере. Но проще начать с LiveKit Cloud: регистрируетесь, создаёте проект, получаете три переменные — URL сервера и пару API-ключей для аутентификации агента в вашем проекте.
Бесплатный план (Build): 1 000 минут агентских сессий в месяц, до 5 параллельных сессий, 5 000 WebRTC-минут для конечных пользователей. Для разработки и прототипов хватает. Платный тариф — от 50 дол./мес, превышение тарификуется по 0,01 дол. за минуту агентской сессии. Self-hosted вариант бесплатен, но требует своей инфраструктуры.
Для самого LiveKit нужны три переменные: адрес сервера и пара ключей проекта — LIVEKIT_URL, LIVEKIT_API_KEY, LIVEKIT_API_SECRET. Все шесть значений (три AI-провайдера плюс LiveKit) удобно сложить в файл .env рядом с кодом:
OPENAI_API_KEY=sk-...
DEEPGRAM_API_KEY=...
CARTESIA_API_KEY=...
LIVEKIT_URL=wss://my-project.livekit.cloud
LIVEKIT_API_KEY=APIxxxxxxxx
LIVEKIT_API_SECRET=xxxxxxxx
Загрузить его в скрипт можно через python-dotenv:
from dotenv import load_dotenv
load_dotenv()  # читает .env из текущей директории
Если запускаете агента через CLI LiveKit (python agent.py dev), .env подхватывается автоматически — явный load_dotenv() тогда не нужен. Ключи и URL проекта LiveKit выдаются в личном кабинете LiveKit Cloud при создании проекта.
Agent: поведение и системный промпт
Объект Agent описывает, что агент делает. Минимально ему нужны инструкции — instructions. Это и есть голосовой системный промпт, который мы уже собирали ранее: роль, требование коротких реплик без восклицаний, фраза-заполнитель на время обращения к данным. Тот же промпт переносится сюда почти без изменений.
session.start: запуск разговора
Вызов await session.start(room=ctx.room, agent=...) запускает разговор: сессия подключается к комнате на медиасервере, начинает слушать звук и ведёт диалог по правилам из instructions. С этого момента весь цикл — слушать, ловить конец реплики, думать, говорить, замолкать при перебивании — крутится сам.
Что включилось без единой строки от нас
Стоит отдельно отметить, что мы получили бесплатно. Переход хода обеспечивает плагин turn-detector: MultilingualModel понимает по смыслу фразы, договорил человек или взял паузу посреди мысли, — это точнее, чем ждать фиксированную паузу тишины. Перебивания обрабатываются адаптивно: если человек заговорил поверх агента, сессия обрывает синтез и переключается на слушание. Стриминг ответа в синтез встроен: текст из модели уходит в TTS по мере генерации, агент начинает озвучивать ответ, не дожидаясь его конца. Всё то, что без фреймворка пришлось бы стыковать руками, здесь уже работает.
Инструменты: как агент вызывает функции
Голосовой агент почти всегда нужно подключить к данным — расписанию, CRM, базе заказов. В LiveKit Agents это делается через function tools: обычные Python-функции с декоратором @function_tool. Их описание уходит в языковую модель, и та вызывает нужную функцию сама — по смыслу реплики клиента.
from livekit.agents import Agent, AgentSession, function_tool

@function_tool
async def get_schedule(day: str, doctor: str) -> str:
    """Проверить свободные окна в расписании клиники.

    Args:
        day: День недели, например «среда» или «четверг».
        doctor: Специализация врача, например «невролог».
    """
    # В реальном коде — запрос к CRM или базе данных
    slots = {"среда": "15:00, 16:30", "четверг": "10:00"}
    return slots.get(day, "нет свободных окон")


session = AgentSession(
    vad=silero.VAD.load(),
    stt=deepgram.STT(model="nova-3", language="multi"),
    llm=openai.LLM(model="gpt-5.4-mini"),
    tts=cartesia.TTS(),
    turn_handling=TurnHandlingOptions(turn_detection=MultilingualModel()),
)

await session.start(
    room=ctx.room,
    agent=Agent(
        instructions=(
            "Ты — голосовой администратор клиники. "
            "Для проверки расписания используй инструмент get_schedule."
        ),
        tools=[get_schedule],
    ),
)
Когда клиент говорит «хочу к неврологу в среду», модель сама решает вызвать get_schedule(day="среда", doctor="невролог") и подставляет результат в ответ. В этот момент агент произносит фразу-заполнитель из промпта — «секунду, смотрю» — пока функция выполняется, пауза не ощущается паузой.
Где запускать: LiveKit Cloud или свой сервер
Агенту нужен медиасервер, и тут два пути. LiveKit Cloud — управляемая платформа: медиасервер и запуск агентов на стороне LiveKit, вы заливаете код. Тарификация идёт в agent session minutes — минутах активного нахождения агента в разговоре. Тиры: Build (бесплатный, с месячным лимитом минут), Ship и Scale (платные, выше лимиты и SLA), Enterprise (по договору). Сверх лимита — порядка одного цента за agent-минуту.
Тарифы LiveKit Cloud на июнь 2026 — Build бесплатный (~1000 agent-минут/мес), Ship (~50 долл./мес), Scale (~500 долл./мес), overage ~0,01 долл. за минуту. Цены и лимиты меняются — сверить можно на livekit.io/pricing.
Второй путь — полный self-host. И фреймворк, и медиасервер LiveKit открытые, поэтому весь стек можно развернуть на своих серверах. Платформенных платежей за минуты нет, но инфраструктуру вы держите сами.
Российский контур и 152-ФЗ
Готовых плагинов под российские сервисы — Yandex SpeechKit, SaluteSpeech, YandexGPT, GigaChat — в LiveKit нет. Подключить российский стек можно кастомной обёрткой: наследуете базовый класс плагина и реализуете вызовы нужного API. Как это делается — разбирается в уроке «LiveKit: обёртки для российского стека». С self-host-развёртыванием серверы реально держать в России, что снимает часть вопросов по 152-ФЗ.
Задача 1
Какой слой работы голосового агента берёт на себя фреймворк-оркестратор вроде LiveKit Agents?
Задача 2
Что из перечисленного при ручной сборке голосового агента из компонентов M2–M3 пришлось бы держать самому, а на фреймворке работает без вашего кода? Выберите все подходящие варианты.
Задача 3
Какую роль играет AgentSession в LiveKit Agents?
Задача 4
Сопоставьте плагин LiveKit с тем слоем пайплайна, который он закрывает.
Сопоставьте элементы
Задача 5
Вы устанавливаете pip install "livekit-agents[openai,silero,deepgram,cartesia,turn-detector]". Что означают имена в квадратных скобках?
Задача 6
Расставьте действия в коде агента LiveKit в порядке их выполнения.
Расположите элементы в правильном порядке
- 1.Запустить разговор через <code>session.start(room=..., agent=...)</code>
- 2.Описать поведение в <code>Agent(instructions=...)</code>
- 3.Создать <code>AgentSession</code> с плагинами STT/LLM/TTS/VAD
- 4.Зарегистрировать <code>entrypoint</code> на <code>AgentServer</code> декоратором <code>@server.rtc_session()</code>
Задача 7
В статье 2024 года агент собран на классе VoicePipelineAgent. Почему в новом проекте на ветке 1.x так писать не стоит?
Задача 8
Как агент на LiveKit Agents обращается к внешним данным — расписанию, CRM, базе заказов?
Задача 9
Для каждой характеристики отметьте подходящий вариант размещения агента LiveKit.
Сопоставьте элементы
Задача 10
Команда хочет собрать на LiveKit агента на российском стеке: YandexGPT и Yandex SpeechKit. Как обстоит дело с готовыми плагинами?
Продолжить с сохранением прогресса
Перейдите к уроку в учебном кабинете.

