
Классический пайплайн: STT — LLM — TTS
Содержание курса
Классический подход: три блока, одна цепочка
Исторически сложившаяся архитектура голосового агента — каскадный пайплайн из трёх независимых компонентов, которые передают данные друг другу последовательно.
Что происходит внутри одного звонка
Клиент говорит: «Свободна ли запись на 15:00 на завтра?». Вот что происходит за следующие секунды:
- STT (Speech-to-Text) слышит голос и превращает его в текст:
"Свободна ли запись на 15:00 на завтра?". - LLM (Large Language Model) получает этот текст вместе с историей диалога, решает вызвать функцию проверки расписания, получает ответ из CRM и генерирует реплику:
"Завтра в 15:00 свободно, записать вас?" - TTS (Text-to-Speech) превращает эту строку в голос и отправляет клиенту.
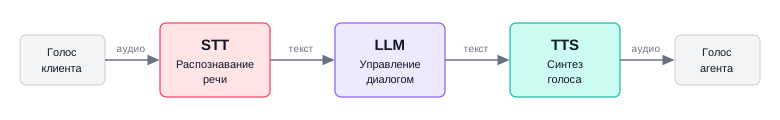
На стыках данные меняют формат: аудио → текст → текст → аудио. Каждый компонент — отдельный сервис с понятным интерфейсом. Следующие три шага разбирают STT, LLM и TTS по отдельности.
Главное преимущество этой архитектуры — гибкость: можно выбирать компоненты независимо, заменять один провайдер без переделки остальных, использовать российские сервисы там, где требует 152-ФЗ. Главный недостаток — суммарная задержка: аудио проходит три отдельных сервиса, каждый добавляет время. Как с этим работает альтернативный realtime-подход — в следующем уроке.
Ошибки в цепочке суммируются
STT вернул мусор — LLM коротко ответит, что не понял вопроса. LLM вернул markdown — TTS зачитает звёздочки и маркеры вслух. Проблема проявляется в конце цепочки, а причина — в начале или середине. Это значит, что диагностировать нужно с первого компонента