UNION и UNION ALL
Содержание курса
До сих пор каждый запрос работал с одной таблицей или соединял несколько через JOIN — то есть расширял строки по горизонтали, добавляя столбцы из связанных таблиц. UNION делает противоположное: берёт результаты двух отдельных SELECT и склеивает их по вертикали, добавляя строки снизу.
UNION: синтаксис склейки двух SELECT, требования к столбцам и удаление дубликатов
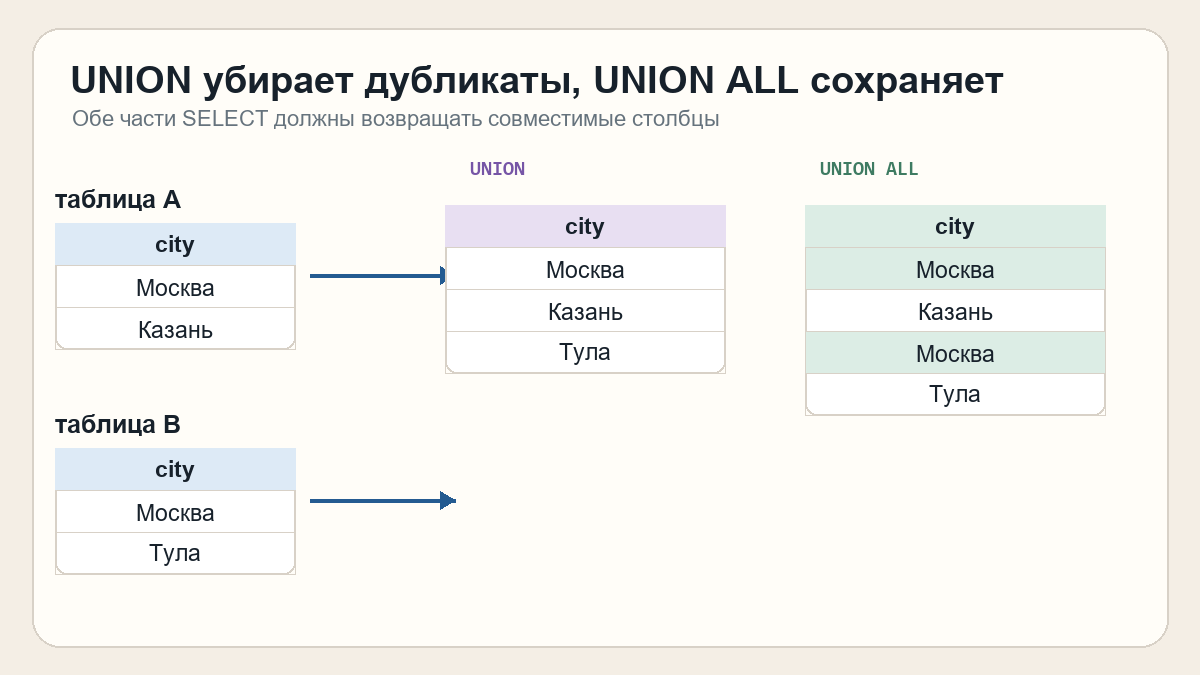
Представьте две таблицы: offices с городами офисов и warehouses с городами складов. Нужен единый список всех городов присутствия. JOIN здесь не поможет — между таблицами нет смыслового ключа для соединения. Именно для этого существует UNION.
Базовый синтаксис:
SELECT city FROM offices
UNION
SELECT city FROM warehouses;
SQLite выполнит оба SELECT, соберёт все строки в один промежуточный набор и вернёт результат как единую таблицу. Имена столбцов в итоге — из первого SELECT. Если нужен конкретный заголовок, псевдоним ставится тоже в первом запросе:
SELECT city AS location FROM offices
UNION
SELECT city FROM warehouses;
Второй AS здесь игнорируется — заголовок всегда определяет первый SELECT.
У UNION есть одно строгое синтаксическое требование: оба SELECT должны возвращать одинаковое число столбцов. Соответствующие позиции также должны иметь совместимый смысл и типы — это правило переносимого SQL и нормальной модели данных. SQLite из-за динамической типизации может выполнить объединение со значениями разных типов в одной позиции, но полагаться на это не стоит; для явного результата используйте CAST.
Если нарушить первое условие — например, в одном SELECT два столбца, а в другом три — база вернёт ошибку вида each UNION query must have the same number of columns. Исправление простое: выровнять число столбцов, добавив константу или NULL как заглушку:
SELECT city, region FROM offices
UNION
SELECT city, NULL FROM warehouses;
Теперь о главном поведении UNION — удалении дубликатов. После склейки UNION проходит по всему набору строк и выбрасывает те, которые полностью совпадают по значениям всех столбцов. Это работает аналогично SELECT DISTINCT, только применяется ко всему результату объединения. Если «Казань» есть и в offices, и в warehouses, в итоговом результате она появится ровно один раз.
Механизм дедупликации требует дополнительной работы от СУБД: она должна сравнить каждую строку с уже виденными. На больших объёмах это заметно сказывается на скорости. Когда дубликаты в результате нежелательны и данные с перекрытием — UNION оправдан. Когда нужна максимальная скорость или дубликаты важны, это уже другой инструмент — о нём в следующей секции.