
Инструменты и окружение CV-инженера
Содержание курса
Кто из них зачем
В requirements.txt курса десяток библиотек, а в статьях по теме их называют вдвое больше. Разберём каждую коротко: что делает, чем удобна, чем нет, и как быстро проверить, что она работает. Отдельно посмотрим на пары, которые делают одно и то же, — выбирать приходится именно между ними.
Обработка кадра
OpenCV — чтение, изменение размера, цветовые переходы, рисование, работа с видео. Быстрая, умеет почти всё, но интерфейс достался от библиотеки на C++: аргументы позиционные, имена сокращённые, порядок каналов BGR. Именно на ней мы читали и переводили кадр в начале урока.
albumentations — аугментации: случайные искажения кадра перед подачей в модель. Отражение, поворот, обрезка, сдвиг яркости, шум, вырезанный кусок, наложенные капли дождя или дымка тумана — из одной фотографии получается десяток непохожих, и обучающий набор растёт без новой съёмки и новой разметки. Дело не в объёме: модель, которая видела товар только с одного ракурса и при одном свете, на другом ракурсе и другом свете ошибается, а искажения не дают ей принять условия съёмки за признак предмета. Достоинство библиотеки в том, что вместе с кадром она пересчитывает рамки, маски и ключевые точки — повернули кадр, повернулась и разметка; это ровно то место, где ручной код ошибается чаще всего. Минус — работает с массивами numpy на процессоре, по одному кадру.
import albumentations as A

pipeline = A.Compose([A.HorizontalFlip(p=1.0), A.Resize(224, 224)])
print(pipeline(image=rgb)["image"].shape)   # (224, 224, 3)
Kornia — те же преобразования, но написанные поверх PyTorch: на входе тензор, обрабатывается сразу весь пакет и на видеокарте. Плюс — скорость и то, что преобразования дифференцируемы, то есть могут стоять прямо внутри сети. Минус — набор готовых аугментаций беднее, а данные надо приводить к виду PyTorch.
import kornia, torch

pipeline = torch.nn.Sequential(kornia.augmentation.RandomHorizontalFlip(p=1.0)).cuda()
batch = torch.from_numpy(frames).permute(0, 3, 1, 2).cuda().float().div(255)
print(pipeline(batch).shape)                # (32, 3, 640, 640)
albumentations или Kornia
Обе цепочки прогнаны на одном пакете из 32 кадров 640×640, замер — медиана двадцати повторов:
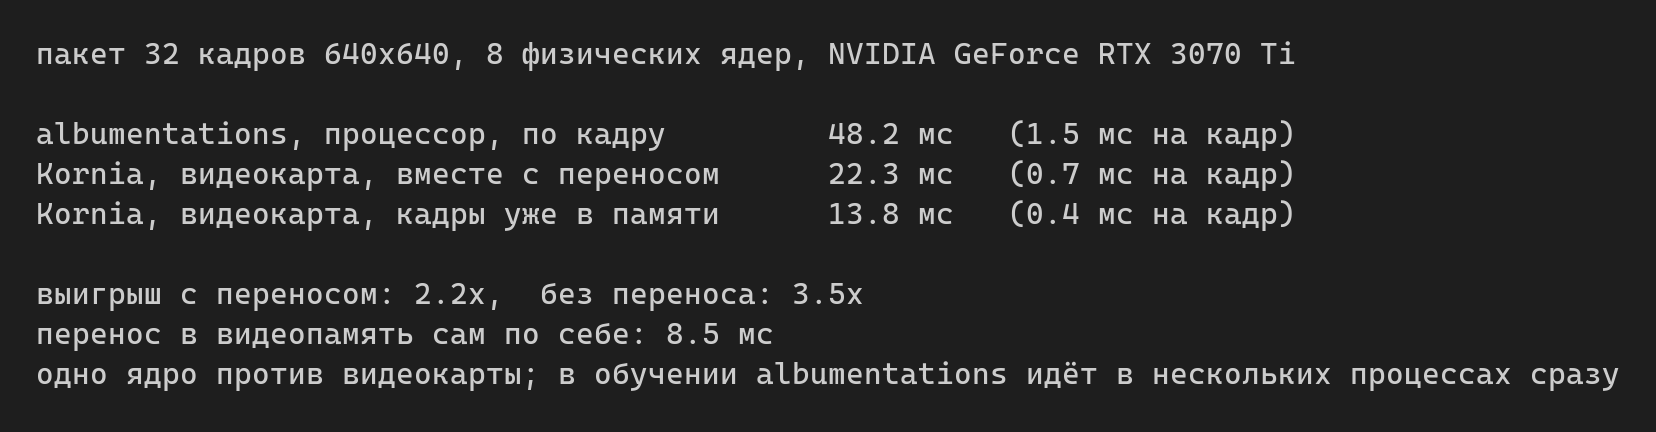
Видеокарта быстрее, но решает здесь строчка про перенос: сами преобразования занимают 13,8 мс, а доставка кадров из оперативной памяти в видеопамять — ещё 8,5 мс сверху. Выигрыш падает с 3,5 раза до 2,2. А теперь главное: в обучении данные готовит не одно ядро, а несколько процессов сразу — на этой машине их восемь. Разделите 48,2 мс на восемь, получите около 6 мс: процессор в таком режиме обгоняет видеокарту с её 22,3 мс вместе с переносом.
Отсюда правило выбора. Кадры читаются с диска и всё равно проходят через процессор — аугментации остаются на нём. Kornia окупается там, где данные уже лежат в видеопамяти, или когда ядер мало. В курсе аугментации сделаны на albumentations.
Модели
torchvision — спутник PyTorch: отдельный пакет, но ставится той же командой, что и torch, а если в окружении есть Ultralytics, придёт и без спроса — он от него зависит. Внутри две разные вещи.
Первая — кирпичи, из которых собраны детекторы, все на C++ и CUDA, а не на чистом Python. Операции над рамками (box_iou — какую долю площади делят между собой две рамки, box_convert — перевод координат из «два угла» в «центр и размеры», и другие), отбор рамок (nms, Non-Maximum Suppression, — оставляет одну рамку там, где сеть выдала десяток на один и тот же объект, batched_nms делает то же по классам), вырезание признаков под рамкой (roi_align, roi_pool), функции потерь (sigmoid_focal_loss, ciou_loss) и готовые слои (DeformConv2d, FeaturePyramidNetwork). Вторая — модели с весами: Faster R-CNN, Mask R-CNN, RetinaNet, Keypoint R-CNN, SSD, FCOS, для сегментации FCN, DeepLabv3 и LRASPP.
Минус — возраст второй части. Самое свежее там, FCOS, добавлено в 2022 году, новых архитектур с тех пор не появилось, а в 2025-м команда объявила, что models и datasets больше не в приоритете и новых возможностей там не будет: силы уходят в предобработку. На кирпичи из ops это не распространяется — они и сегодня стоят под капотом у половины остального.
from torchvision.ops import box_iou
a, b = torch.tensor([[0., 0., 10., 10.]]), torch.tensor([[5., 5., 15., 15.]])
print(box_iou(a, b))   # 0.1429
timm — коллекция классификаторов: около 1300 архитектур и 1700 наборов весов, и к каждому набору своя правильная предобработка. Плюс — модель приходит обычным nn.Module: в PyTorch это базовый класс, из которого сделаны и отдельный слой, и целая сеть, — он хранит веса и умеет прогнать через себя данные. Практически это значит, что модель из timm не закрытый объект библиотеки, а обычный код PyTorch: слои можно распечатать, последний снять и поставить свой на нужное число классов, нижнюю часть заморозить, всю модель вставить куском в свою сеть — тем же способом, каким вы это делаете с собственными слоями, без отдельного API библиотеки. Минус — это только классификация, всё остальное собирайте сами.
import timm
model = timm.create_model("resnet50.a1_in1k", pretrained=True).eval()
print(model(batch).softmax(dim=1).topk(1))
transformers — то же самое для всего остального современного: детекторы линии DETR и D-FINE, сегментация, детекция по текстовому запросу, распознавание документов. В версии, что стоит у нас, одних только классов детекции и сегментации 28 штук. Плюс — сюда первыми попадают новые архитектуры. Минус — библиотека огромная и общая, под зрение не заточена.
Ultralytics — не коллекция, а готовый инструмент: сам качает веса, готовит кадр, применяет порог, убирает лишние рамки, умеет обучать и экспортировать. Название совпадает с названием главного семейства моделей, и из-за этого её часто считают обёрткой вокруг YOLO. На деле тем же вызовом запускаются и чужие архитектуры:
from ultralytics import YOLO, RTDETR, SAM, FastSAM, NAS, YOLOWorld, YOLOE

result = YOLO("yolo11n.pt").predict(frame, conf=0.25, device=0)[0]
print(len(result.boxes), result.names[int(result.boxes.cls[0])])
RTDETR — трансформерный детектор из другой линии, SAM и FastSAM — сегментация по подсказке, YOLOWorld и YOLOE — детекция по тексту. Интерфейс у всех один. Плюс — до рабочего результата несколько строк. Минус — за пределы этого интерфейса выйти трудно: своя функция потерь или нестандартная голова означают правку внутренностей. И отдельно — лицензия: Ultralytics раздаётся по AGPL-3.0, и для закрытого продукта это означает либо открытие своего кода, либо покупку коммерческой лицензии.
Detectron2 и MMDetection — исследовательские фреймворки: модель, оптимизатор, расписание и метрики описываются конфигом, а код обучения общий. Так удобно ставить эксперименты, и так устроены исходники многих статей. Проблема у обоих одна:
| Фреймворк | Последний выпуск | Изменения в коде |
|---|---|---|
| MMDetection | 3.3.0, январь 2024 | ничего с февраля 2024 |
| Detectron2 | 0.6, ноябрь 2021 | идут, но это правка типов и внутренние проверки Meta |
Проверено по репозиториям 8 августа 2026. Архитектур последних двух лет там не будет, а собирать их придётся под те версии PyTorch и CUDA, что были актуальны тогда; установка MMDetection на свежее окружение упирается в подбор совместимой версии mmcv. Брать их стоит в одном случае: вы воспроизводите статью, исходники которой лежат под этот фреймворк.
Как выбирать между ними
Порядок такой: начните с самого готового и спускайтесь ниже, только когда упрётесь. Типовая детекция или сегментация на своих данных — Ultralytics, и через час у вас обученная модель. Нужна архитектура, которой там нет, или модель должна стать частью вашей сети — transformers и timm. Нужны свои потери и свой цикл обучения — тот же уровень, только код обучения ваш. Обратный порядок, от фреймворка, — самый частый способ потерять неделю на сборку окружения до первого прогона.
Отрисовка
Ответ модели надо увидеть, и здесь тоже есть выбор из двух. Рисовать умеет сам OpenCV — рамка, фон под текст, подпись:
cv2.rectangle(canvas, (x1, y1), (x2, y2), (0, 165, 255), 3)
cv2.putText(canvas, f"банан {score:.2f}", (x1, y1 - 6),
            cv2.FONT_HERSHEY_SIMPLEX, 0.6, (255, 255, 255), 1)
supervision делает то же самое короче:
import supervision as sv

detections = sv.Detections.from_ultralytics(result)
canvas = sv.BoxAnnotator(thickness=3).annotate(frame.copy(), detections)
canvas = sv.RichLabelAnnotator(font_path="arial.ttf").annotate(canvas, detections, labels)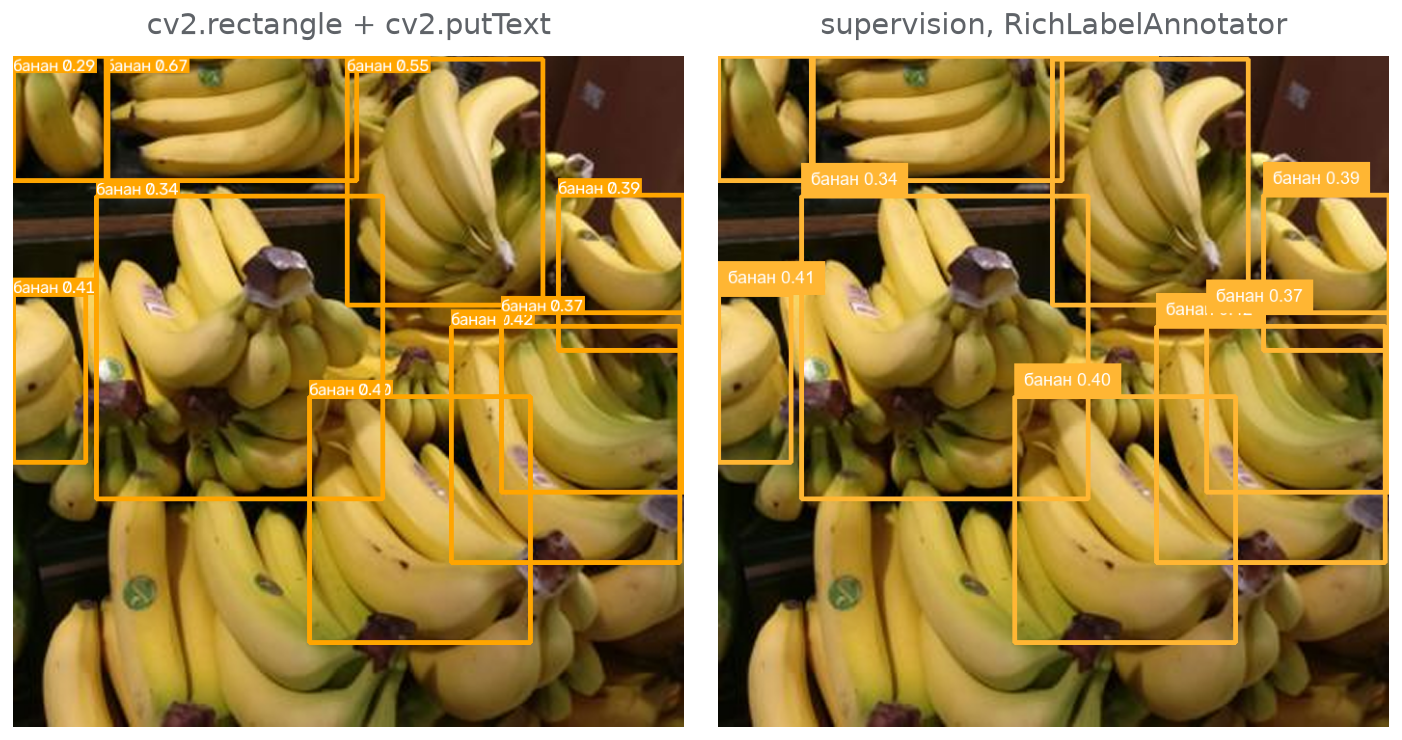
Результат почти одинаковый, и это честный итог: для одного кадра с рамками OpenCV достаточно, а утверждение «нужен supervision, чтобы рисовать» — преувеличение. Видимая разница одна: у верхних рамок подпись упирается в край кадра, и слева она обрезается, а справа сдвинута внутрь.
Настоящая причина держать supervision — другая. Ответы детекторов у всех разные: у Ultralytics это result.boxes, у моделей из transformers — словарь тензоров, у Detectron2 свой объект, у OCR-движков — строки с координатами. Supervision приводит их к одному типу Detections, и таких переходников в нашей версии семнадцать. Весь код отрисовки, фильтрации и подсчёта после этого перестаёт зависеть от того, какая модель под ним стоит. Второе — тридцать два готовых способа рисования: маски и полигоны, следы объектов на видео, зоны подсчёта и линии пересечения, тепловая карта, размытие лиц. Каждое пишется руками за вечер, и каждое второе — с ошибками на границах кадра.
Проверка целиком
Соберите проверки выше в один файл и запустите. Своей видеокарты для этого не нужно: device=0 заменяется на device="cpu", .cuda() убирается — на одном кадре разница будет в секундах. Если нужно прогнать всё как есть, откройте блокнот в Colab или Kaggle, как разобрано на прошлом шаге. Вот как файл отработал на нашем кадре — классификатор из timm и детектор из Ultralytics на одной фотографии:
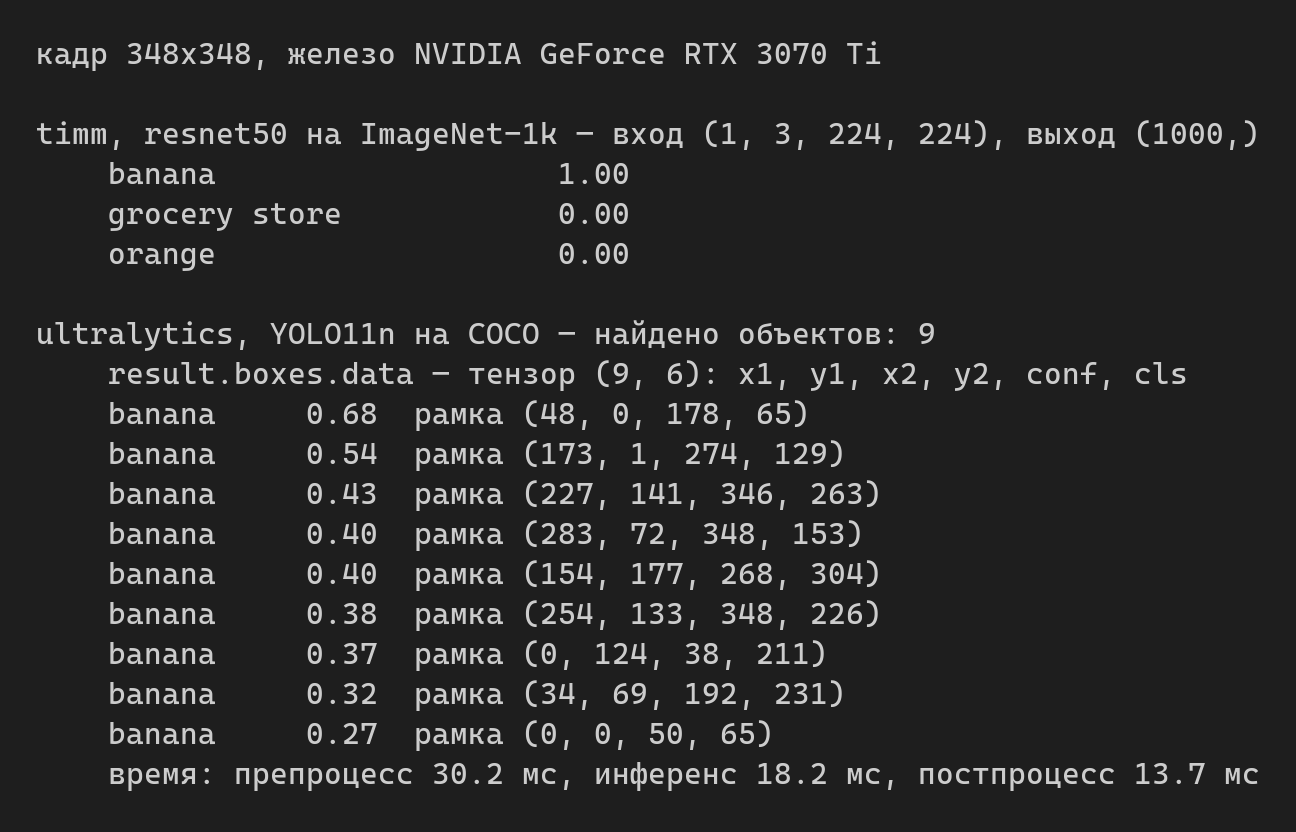
Классификатор ответил одной меткой на весь кадр — banana с уверенностью 1.00. Детектор ответил тензором (9, 6): девять строк по шесть чисел, четыре координаты, уверенность и номер класса. Ниже — время: препроцесс 30,2 мс, инференс 18,2 мс, постпроцесс 13,7 мс на видеокарте с 8 ГБ видеопамяти. Сама сеть здесь треть времени, подготовка кадра и разбор ответа стоят дороже неё.
И посмотрите ещё раз на картинку с рамками. Бананов на кадре несколько десятков, а рамок девять, и стоят они на связках, а не на отдельных плодах. Формально детектор прав, класс banana в COCO есть. Практически ответ бесполезен: посчитать по нему товар нельзя. Числа в консоли этого не показывают — ответ модели проверяется картинкой.
Кадр — набор Grocery Store (Marcus Klasson), MIT; предсказания нанесены поверх.