
Урок курса
UNION и UNION ALL
SQL с нуля: бесплатный курс с практикойДо сих пор каждый запрос работал с одной таблицей или соединял несколько через JOIN — то есть расширял строки по горизонтали, добавляя столбцы из связанных таблиц. UNION делает противоположное: берёт результаты двух отдельных SELECT и склеивает их по вертикали, добавляя строки снизу.
UNION: синтаксис склейки двух SELECT, требования к столбцам и удаление дубликатов
Представьте две таблицы: offices с городами офисов и warehouses с городами складов. Нужен единый список всех городов присутствия. JOIN здесь не поможет — между таблицами нет смыслового ключа для соединения. Именно для этого существует UNION.
Базовый синтаксис:
SELECT city FROM offices
UNION
SELECT city FROM warehouses;
SQLite выполнит оба SELECT, соберёт все строки в один промежуточный набор и вернёт результат как единую таблицу. Имена столбцов в итоге — из первого SELECT. Если нужен конкретный заголовок, псевдоним ставится тоже в первом запросе:
SELECT city AS location FROM offices
UNION
SELECT city FROM warehouses;
Второй AS здесь игнорируется — заголовок всегда определяет первый SELECT.
У UNION есть одно строгое синтаксическое требование: оба SELECT должны возвращать одинаковое число столбцов. Соответствующие позиции также должны иметь совместимый смысл и типы — это правило переносимого SQL и нормальной модели данных. SQLite из-за динамической типизации может выполнить объединение со значениями разных типов в одной позиции, но полагаться на это не стоит; для явного результата используйте CAST.
Если нарушить первое условие — например, в одном SELECT два столбца, а в другом три — база вернёт ошибку вида each UNION query must have the same number of columns. Исправление простое: выровнять число столбцов, добавив константу или NULL как заглушку:
SELECT city, region FROM offices
UNION
SELECT city, NULL FROM warehouses;
Теперь о главном поведении UNION — удалении дубликатов. После склейки UNION проходит по всему набору строк и выбрасывает те, которые полностью совпадают по значениям всех столбцов. Это работает аналогично SELECT DISTINCT, только применяется ко всему результату объединения. Если «Казань» есть и в offices, и в warehouses, в итоговом результате она появится ровно один раз.
Механизм дедупликации требует дополнительной работы от СУБД: она должна сравнить каждую строку с уже виденными. На больших объёмах это заметно сказывается на скорости. Когда дубликаты в результате нежелательны и данные с перекрытием — UNION оправдан. Когда нужна максимальная скорость или дубликаты важны, это уже другой инструмент — о нём в следующей секции.
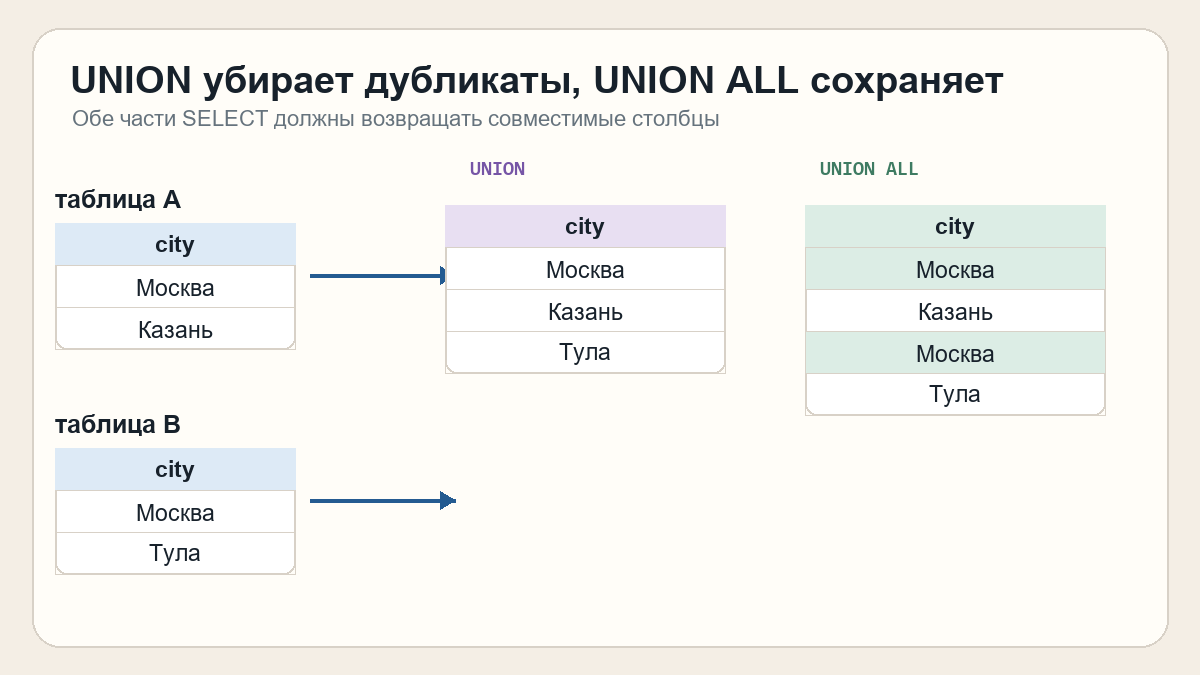
UNION ALL: сохранение всех строк и наблюдаемая разница в количестве строк
Создадим учебную базу из примера и сравним оба варианта в цифрах:
CREATE TABLE offices (city TEXT);
INSERT INTO offices VALUES ('Москва'), ('Казань'), ('Самара');

CREATE TABLE warehouses (city TEXT);
INSERT INTO warehouses VALUES ('Казань'), ('Уфа');
Теперь два запроса на одних и тех же данных:
-- Вариант 1
SELECT city FROM offices
UNION
SELECT city FROM warehouses;

-- Вариант 2
SELECT city FROM offices
UNION ALL
SELECT city FROM warehouses;
Первый вернёт 4 строки: Москва, Казань, Самара, Уфа — «Казань» из warehouses отброшена как дубликат. Второй вернёт 5 строк: те же четыре плюс вторую «Казань». UNION ALL не делает никакой проверки — он просто дописывает строки второго SELECT снизу к строкам первого. Если в первом запросе N строк, а во втором M, результат UNION ALL содержит ровно N + M строк, без исключений.
Чтобы увидеть разницу числом, достаточно обернуть оба запроса в COUNT(*):
SELECT COUNT(*) FROM (
    SELECT city FROM offices
    UNION
    SELECT city FROM warehouses
);
-- результат: 4

SELECT COUNT(*) FROM (
    SELECT city FROM offices
    UNION ALL
    SELECT city FROM warehouses
);
-- результат: 5
Разница в одну строку — это именно «Казань», которую UNION обнаружил и убрал при сравнении со строкой из первого SELECT.
Когда стоит выбирать UNION ALL? Во-первых, когда дубликаты несут смысл — например, нужно подсчитать, сколько раз один и тот же город встречается в обеих таблицах. Во-вторых, когда данные заведомо не пересекаются и тратить время на дедупликацию бессмысленно. В-третьих, когда объём большой и производительность важна: UNION ALL не строит временный набор для сравнения строк, он просто конкатенирует результаты.
Практическое правило: пишите UNION ALL по умолчанию, если точно знаете структуру данных. Переключайтесь на UNION, когда нужна гарантия уникальности строк в результате и готовы заплатить за неё скоростью.
Задача 1
table_a содержит 6 различных значений col, table_b — 4 различных значения col. Ровно 3 значения встречаются в обоих результатах; других совпадений нет. Сколько строк вернут два запроса?
Запрос 1: SELECT col FROM table_a UNION ALL SELECT col FROM table_b;
Запрос 2: SELECT col FROM table_a UNION SELECT col FROM table_b;
Задача 2
Аналитик пишет запрос:
SELECT name FROM clients UNION SELECT name, email FROM suppliers;
Что произойдёт при выполнении этого запроса?
Задача 3
В каком SELECT нужно задать псевдоним AS, чтобы изменить заголовок столбца в результате UNION? Введите только номер: 1 или 2.
Задача 4
Все города из двух источников
Есть две таблицы с одним столбцом: online_customers(city) и store_customers(city). Напишите один запрос, который возвращает один столбец city со всеми строками обоих источников, включая повторяющиеся города. Используйте UNION ALL, а не UNION, и отсортируйте итоговый результат по city по возрастанию.
Без регистрации. Гостевая проверка не сохраняет прогресс. Для сохранения перейдите к уроку.
Отправьте решение, чтобы увидеть результаты тестов.
Задачи к уроку
- UNION в SQL: разное число столбцов в SELECT
Разберите объединение клиентов и поставщиков, где SELECT возвращают разные наборы полей. Определите результат выполнения.
Продолжить с сохранением прогресса
Перейдите к уроку в учебном кабинете.

