
Урок курса
MAE, MSE, RMSE и единицы ошибки
Машинное обучение с нуля на Python: первая модельВ прошлом уроке вы научились читать коэффициенты модели и вручную воспроизводить предсказание по формуле. Но коэффициенты сами по себе не говорят, насколько точна модель в целом. Чтобы это выяснить, нужно сравнить предсказания на тестовой выборке с истинными значениями — и измерить расхождение конкретным числом.
MAE, MSE и RMSE: формулы, единицы и поведение штрафа
Все три метрики измеряют одно и то же — насколько предсказание расходится с истинным значением — но по-разному реагируют на величину ошибки.
MAE — это просто среднее абсолютных отклонений:
MAE = (1/n) * Σ |y_pred[i] - y_true[i]|
Абсолютное значение убирает знак, и ошибка на 10 единиц вносит ровно вдвое больший вклад, чем ошибка на 5. Единицы MAE совпадают с единицами целевой переменной — если цель в рублях, MAE тоже в рублях.
MSE возводит каждое отклонение в квадрат перед усреднением:
MSE = (1/n) * Σ (y_pred[i] - y_true[i])²
Здесь ошибка на 10 единиц вносит уже в четыре раза больший вклад, чем ошибка на 5, — потому что 10² / 5² = 4. Это «непропорциональный» штраф: крупная единичная ошибка доминирует над многими мелкими. Обратная сторона — единицы MSE становятся квадратными. Если целевая переменная в рублях, MSE окажется в рублях², и это число интуитивно не читается.
RMSE исправляет проблему единиц, извлекая корень:
RMSE = √MSE
Единицы RMSE снова совпадают с целевой переменной, как у MAE. Но чувствительность к крупным ошибкам никуда не делась — квадрат внутри MSE всё ещё работает. Поэтому на одних и тех же данных RMSE ≥ MAE всегда. Если все ошибки одинаковы по модулю, RMSE = MAE; как только разброс ошибок растёт, разрыв увеличивается.
Сравните три ошибки на мини-примере вручную, чтобы почувствовать разницу:
| i | y_true | y_pred | ошибка | абсолютная ошибка | ошибка² |
|---|---|---|---|---|---|
| 1 | 100 | 105 | +5 | 5 | 25 |
| 2 | 200 | 190 | −10 | 10 | 100 |
| 3 | 150 | 180 | +30 | 30 | 900 |
MAE = (5 + 10 + 30) / 3 = 15 MSE = (25 + 100 + 900) / 3 = 341.7 RMSE = √341.7 ≈ 18.5
Ошибка на третьей строке (30) в MAE вносит вклад пропорционально своей величине. В MSE её квадрат (900) составляет 88% суммарного штрафа из трёх строк — именно так квадратичный штраф выделяет крупные промахи.
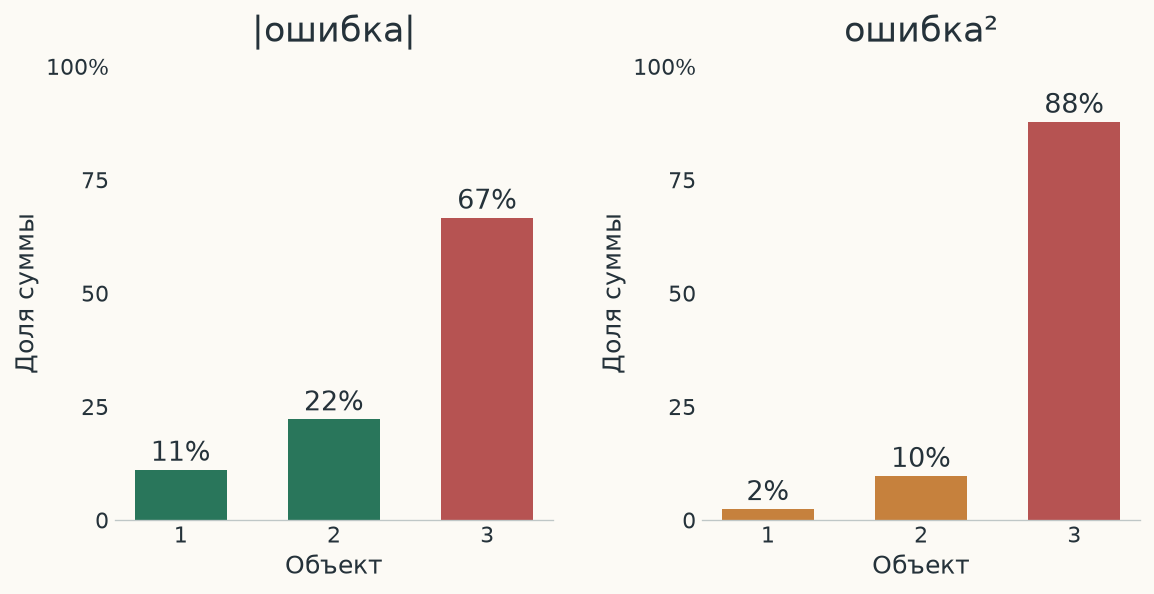
Вычисление метрик через sklearn.metrics и вручную на малом примере
Стандартный способ считать метрики на тестовой выборке — sklearn.metrics. Вот полный рабочий пример на датасете diabetes:
import numpy as np
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, mean_squared_error

bunch = load_diabetes(as_frame=True)
X, y = bunch.data, bunch.target

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

model = LinearRegression()
model.fit(X_train, y_train)
y_pred = model.predict(X_test)

mae  = mean_absolute_error(y_test, y_pred)
mse  = mean_squared_error(y_test, y_pred)
rmse = np.sqrt(mse)

print(f"MAE  = {mae:.2f}")
print(f"MSE  = {mse:.2f}")
print(f"RMSE = {rmse:.2f}")
Оба вызова принимают аргументы в порядке (y_true, y_pred). Если перепутать порядок, sklearn не выдаст ошибку — числа посчитаются, но придерживайтесь правильного порядка: он закреплён в API и важен для других метрик, которые несимметричны.
RMSE получают как np.sqrt(mean_squared_error(...)) — это работает во всех версиях sklearn. Начиная со sklearn 1.4 доступна также отдельная функция root_mean_squared_error из того же модуля, но np.sqrt не создаёт неожиданностей при смене версии.
Чтобы убедиться, что функции sklearn делают именно то, что описано в формулах, возьмём первые пять строк тестовой выборки и повторим расчёт вручную:
y_true_5 = y_test.values[:5]
y_pred_5 = y_pred[:5]

errors = y_pred_5 - y_true_5

mae_manual  = np.mean(np.abs(errors))
mse_manual  = np.mean(errors ** 2)
rmse_manual = np.sqrt(mse_manual)

print(f"MAE  вручную = {mae_manual:.4f},  sklearn = {mean_absolute_error(y_true_5, y_pred_5):.4f}")
print(f"MSE  вручную = {mse_manual:.4f},  sklearn = {mean_squared_error(y_true_5, y_pred_5):.4f}")
print(f"RMSE вручную = {rmse_manual:.4f},  sklearn = {np.sqrt(mean_squared_error(y_true_5, y_pred_5)):.4f}")
Все три пары чисел совпадут до последнего знака — ручной расчёт и библиотечные функции реализуют одни и те же формулы. Разница лишь в удобстве: mean_absolute_error и mean_squared_error принимают любые array-like объекты и корректно работают с pandas Series без дополнительных преобразований.
Интерпретация MAE и RMSE в единицах целевой переменной и сигнал разрыва
Датасет diabetes предсказывает количественный показатель прогрессирования болезни — условная шкала без прямого «рублёвого» смысла, но принцип интерпретации универсален. Допустим, модель показала MAE ≈ 44 и RMSE ≈ 55. Оба числа — в единицах целевой переменной. Это означает: в среднем по тестовым объектам модель ошибается примерно на 44 единицы; при этом типичная «бо́льшая» ошибка, взвешенная квадратичным штрафом, соответствует отклонению порядка 55 единиц.
MSE здесь не интерпретируют напрямую: число вида 2900 в «единицах²» не сопоставимо ни с диапазоном целевой переменной, ни с чем-либо предметным. Именно поэтому RMSE существует — он возвращает метрику в исходное пространство.
Разрыв между RMSE и MAE несёт отдельную информацию. Если RMSE ненамного больше MAE, ошибки примерно одного порядка на всей выборке. Если разрыв заметный — например, MAE = 44, а RMSE = 55 — это значит, что часть предсказаний сильно промахивается: квадрат крупных ошибок тянет MSE вверх, а значит, и RMSE. Сам по себе этот разрыв не говорит, какие именно объекты ошиблись и почему — для этого нужно смотреть на распределение ошибок отдельно. Но он служит первым сигналом: ошибки неоднородны.
Практическое правило: отчитывайтесь о модели числами MAE и RMSE вместе. MAE даёт «средний» промах, понятный без математики. RMSE показывает, насколько модель чувствительна к крупным промахам. Вместе они дают больше, чем каждое число отдельно.
Попробуйте решить
Ручной расчёт MAE, MSE и RMSE
Три самых распространённых метрики — MAE, MSE и RMSE — устроены по-разному. Средняя абсолютная ошибка усредняет модули отклонений, средняя квадратичная — квадраты отклонений, а корень из MSE возвращает результат в единицы цели.
Что уже дано
Видимый код содержит четыре пары actual, predicted, импорт math и библиотечные mean_absolute_error, mean_squared_error. Есть заготовка функции manual_metrics(actual, predicted): она получает два списка равной ненулевой длины и должна вернуть три числа (MAE, MSE, RMSE). Скрытая подготовка не создаёт данные.
Что нужно сделать
Реализуйте manual_metrics самостоятельно по определениям метрик, без вызова библиотечных функций внутри неё. Для четырёх видимых пар сохраните её результаты в mae_manual, mse_manual, rmse_manual; отдельно найдите mae_library, mse_library, rmse_library через sklearn и корень из библиотечного MSE. В matches сохраните три булевых сравнения ручного и библиотечного расчёта с допуском 1e-9. Модель обучать не нужно.
Ввод и вывод
stdin не используется. Печатать через print в stdout ничего не нужно. Проверяются manual_metrics, исходные actual, predicted, шесть чисел и matches; скрытая проверка вызывает вашу функцию и на других парах чисел.
Продолжить с проверкой и прогрессом
Откройте интерактивный раннер с заданиями урока.

