
Урок курса
Введение в DP: перекрывающиеся подзадачи и memoization
Алгоритмы и структуры данных на PythonЖадные алгоритмы дают точный ответ только тогда, когда безопасность локального выбора удаётся доказать. Динамическое программирование строит решение иначе: явно выделяет состояния и сохраняет ответы повторяющихся подзадач. Начнём с этой модели и увидим, откуда берётся выигрыш.
Перекрывающиеся подзадачи: state, base, transition
Динамическое программирование начинается с вопроса: что именно нужно знать, чтобы ответить на подзадачу? Ответ — это и есть состояние (state). Формально: минимальный набор параметров, от которого однозначно зависит результат. Всё, что не входит в state, либо фиксировано глобально, либо несущественно.
Для чисел Фибоначчи state — одно целое число n. В более сложной задаче параметров может быть несколько; важно включить ровно те данные, от которых зависит ответ подзадачи.
Дальше нужны ещё три элемента.
- Base — состояния, ответ для которых известен без рекурсии. Для Фибоначчи это
fib(0) = 0иfib(1) = 1. - Transition — правило, которое выражает ответ для состояния
nчерез ответы для меньших состояний. Для Фибоначчи:fib(n) = fib(n-1) + fib(n-2)приn >= 2. - Answer — то состояние, из которого читается итоговый ответ. Здесь это просто
fib(n)для запрошенногоn.
Общая рекурсия тоже использует базу и переходы — это ещё не DP. Отличительный признак динамического программирования — перекрытие: одно и то же состояние достижимо несколькими путями в дереве рекурсии. Иначе говоря, если развернуть все рекурсивные вызовы, одни и те же аргументы встречаются снова и снова.
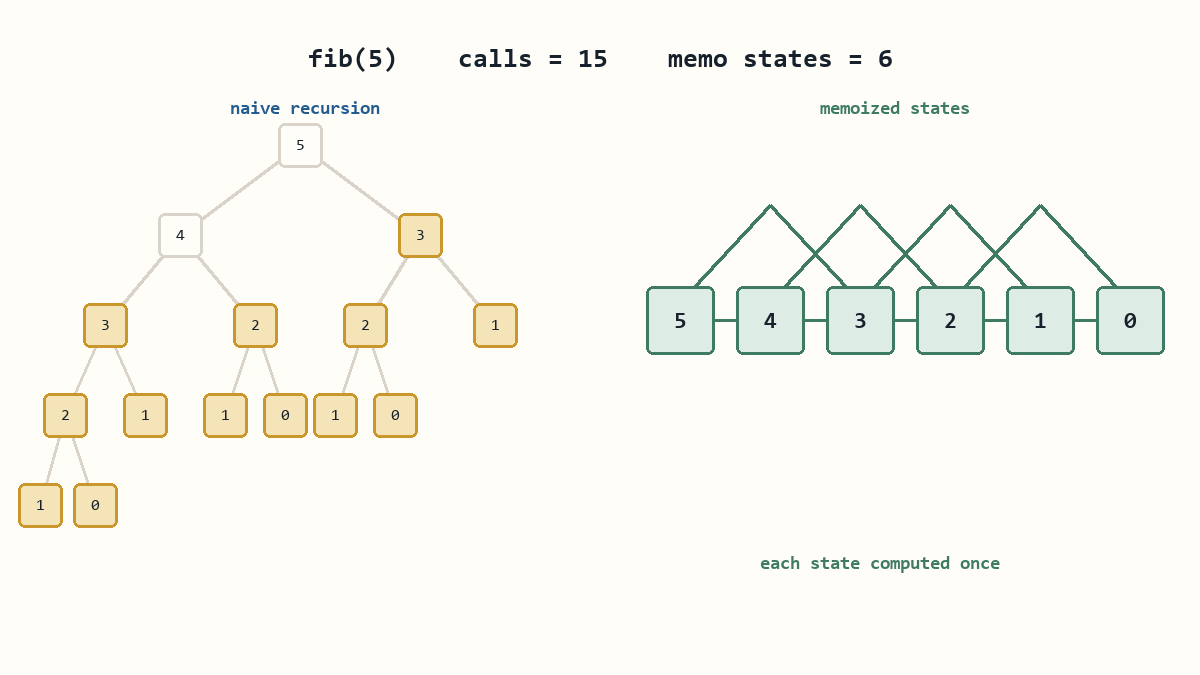
Почему это важно? Потому что без кэша каждый визит в состояние заново выполняет всю работу. С кэшем — вычислили один раз, остальные визиты получают готовый ответ. Число уникальных состояний при этом может быть на порядки меньше числа вызовов: для Фибоначчи уникальных состояний ровно n + 1, тогда как вызовов без кэша — экспоненциально много.
Важная оговорка: само по себе наличие перекрытий ещё не гарантирует, что DP даст оптимальный ответ на задачу оптимизации. Для этого нужна оптимальная подструктура — оптимум состояния должен выражаться через оптимумы меньших состояний. Memoization честно закэширует значения любой записанной рекуррентности, но если сама рекуррентность неверно описывает оптимум, кэш не исправит модель.
Наивная рекурсия Фибоначчи и экспоненциальная сложность
Посмотрим, что происходит, если реализовать переход fib(n) = fib(n-1) + fib(n-2) напрямую — без всякого кэша — и честно посчитать, сколько раз мы входим в тело функции.
calls = 0

def fib_naive(n: int) -> int:
    if n < 0:
        raise ValueError("n должно быть неотрицательным")
    global calls
    calls += 1
    if n <= 1:
        return n
    return fib_naive(n - 1) + fib_naive(n - 2)

for n in [5, 10, 20, 35]:
    calls = 0
    result = fib_naive(n)
    print(f"fib({n}) = {result}, вызовов = {calls}")
Вывод:
fib(5) = 5, вызовов = 15
fib(10) = 55, вызовов = 177
fib(20) = 6765, вызовов = 21891
fib(35) = 9227465, вызовов = 29860703
Число вызовов растёт устрашающе быстро. Разберём, почему.
Пусть T(n) — число входов в тело fib_naive(n), считая в том числе базовые случаи. Тогда:
T(0) = 1,T(1) = 1— базы считают сам свой вызов,T(n) = T(n-1) + T(n-2) + 1приn >= 2— единица это вход в текущий вызов до передачи управления дальше.
Эта рекуррентность решается в терминах чисел Фибоначчи: T(n) = 2·F(n+1) - 1, что даёт T(n) = Θ(φⁿ), где φ = (1 + √5) / 2 ≈ 1.618. Именно поэтому T(35) ≈ 30 миллионов.
Чтобы увидеть корень проблемы, достаточно нарисовать дерево вызовов для fib(5):
fib(5)
├── fib(4)
│   ├── fib(3)
│   │   ├── fib(2)
│   │   │   ├── fib(1)
│   │   │   └── fib(0)
│   │   └── fib(1)
│   └── fib(2)          ← уже было
│       ├── fib(1)
│       └── fib(0)
└── fib(3)              ← уже было
    ├── fib(2)
    │   ├── fib(1)
    │   └── fib(0)
    └── fib(1)
fib(3) вычисляется дважды, fib(2) — трижды, fib(1) и fib(0) — ещё больше. Уникальных состояний всего n + 1 (от 0 до n), но дерево вызовов многократно их посещает. Чем больше n, тем больше перекрытий и тем хуже соотношение «работа / полезный результат».
Это не особенность Фибоначчи — это общая ловушка наивной рекурсии на задачах с перекрывающимися подзадачами.
Memoization через словарь и lru_cache: реализация и замер
Идея проста: раз одни и те же состояния вычисляются снова и снова, запомним ответ при первом вычислении и при повторном обращении просто вернём его из кэша. Дерево вызовов при этом сворачивается в DAG — ориентированный граф без циклов — где каждая вершина (состояние) встречается ровно один раз.
Реализация через явный словарь
def fib_memo(n: int, memo: dict) -> int:
    if n in memo:
        return memo[n]
    memo[n] = fib_memo(n - 1, memo) + fib_memo(n - 2, memo)
    return memo[n]

def fib(n: int) -> int:
    if n < 0:
        raise ValueError("n должно быть неотрицательным")
    return fib_memo(n, {0: 0, 1: 1})

print(fib(10))  # 55
Несколько деталей, которые здесь принципиальны.
Словарь создаётся в обёртке fib, а не как аргумент по умолчанию memo={}. Аргумент по умолчанию — это один объект, разделяемый всеми вызовами функции на протяжении всего времени работы программы. При сигнатуре fib_memo(n, memo={}) два вызова без явного memo, например fib_memo(10) и fib_memo(20), смотрели бы в один и тот же накапливающийся словарь. Это скрытое состояние, которое очень трудно отлаживать.
Контракт: базовые случаи {0: 0, 1: 1} инициализируются до первого рекурсивного вызова, а все вложенные вызовы получают тот же словарь.
Реализация через lru_cache
from functools import lru_cache

@lru_cache(maxsize=None)
def fib_cached(n: int) -> int:
    if n < 0:
        raise ValueError("n должно быть неотрицательным")
    if n <= 1:
        return n
    return fib_cached(n - 1) + fib_cached(n - 2)

fib_cached(10)
info = fib_cached.cache_info()
print(info)  # CacheInfo(hits=8, misses=11, maxsize=None, currsize=11)
lru_cache строит ключ по полному набору аргументов, поэтому они должны быть хешируемыми, а результат — определяться этими аргументами. Если функция читает изменяемое внешнее состояние, старое значение в кэше может стать неверным.
misses=11 означает, что тело функции было выполнено 11 раз — по одному разу для каждого состояния от 0 до 10. hits=8 — это обращения, которые нашли ответ в кэше без исполнения тела. Итого 8 + 11 = 19 обращений к декорированной функции при fib_cached(10), тогда как fib_naive(10) входил в тело 177 раз.
Важно не смешивать эти метрики: «тело выполнено 11 раз» и «кэш обслужил 8 запросов» — разные вещи. Число уникальных вычислений — это misses, а не misses + hits.
Перед повторным экспериментом кэш нужно сбросить:
fib_cached.cache_clear()
fib_cached(10)
print(fib_cached.cache_info())  # снова misses=11, hits=8
Без очистки второй вызов добавит 0 misses и 1 hit; поскольку cache_info() показывает накопительные счётчики, итог станет misses=11, hits=9.
Сложность после memoization
Для fib(n) достижимы состояния 0, 1, ..., n — ровно n + 1 штук. Тело вычисляется для каждого ровно один раз, каждый переход занимает O(1). Итог: время O(n), память O(n) на кэш.
Одно ограничение остаётся: глубина стека Python по-прежнему O(n). При достаточно большом n (по умолчанию лимит около 1000) получим RecursionError. Memoization убирает повторные вычисления, но не меняет природу рекурсии.
Memoization (сверху вниз) против Tabulation (снизу вверх): модель и различия
Memoization — это один из двух способов реализовать динамическое программирование. Оба работают с одной и той же моделью: state, base, transition, answer. Но порядок, в котором они обходят состояния, принципиально разный.
Top-down (memoization) стартует с целевого состояния и рекурсивно спускается к зависимостям. Порядок обхода определяется стеком вызовов: мы не задаём его явно, он выстраивается сам по мере раскрытия рекурсии. Если какое-то состояние оказывается недостижимым из целевого, мы его просто не посещаем — это бывает полезно, когда граф состояний разрежен.
Обратная сторона: стек. При n = 5000 top-down Фибоначчи упадёт с RecursionError в стандартном CPython, даже если кэш работает правильно.
Bottom-up (tabulation) задаёт порядок обхода состояний явно — обычно простым циклом от меньших к большим. Никаких рекурсивных вызовов нет: мы заполняем таблицу в том порядке, который гарантирует, что к моменту вычисления состояния n все его зависимости уже готовы.
Для Фибоначчи bottom-up выглядит как цикл от 2 до n, заполняющий массив или пару переменных. Глубина стека — O(1), потому что рекурсии нет вообще.
Структурное различие можно сформулировать так:
- Порядок: top-down определяется стеком вызовов; bottom-up задаётся явно.
- Недостижимые состояния: top-down пропускает их автоматически; bottom-up обычно заполняет выбранный диапазон.
- Стек: top-down использует
O(глубина рекурсии); bottom-up —O(1)рекурсивного стека. - Переходы: top-down следует зависимостям по запросу; bottom-up требует заранее выбрать корректный порядок.
Оба подхода требуют одинаково корректной модели: если переход записан неверно, ни memoization, ни tabulation не спасут — просто закэшируют или запишут в таблицу неверный ответ. Ошибка в модели воспроизводится стабильно и без предупреждений.
Практический совет: top-down удобен, когда структура зависимостей сложная или граф состояний разрежен. Bottom-up предпочтительнее, когда нужно обработать большие n без риска переполнения стека или когда порядок заполнения таблицы очевиден. Детальная реализация tabulation и восстановление самого решения (а не только его стоимости) — отдельная история, которую мы разберём в следующем уроке.
Задача 1
Наивная рекурсивная функция fib_naive(n) вычисляет fib_naive(n-1) + fib_naive(n-2) без кэша. Сколько раз вызывается fib_naive(2) при вычислении fib_naive(5)?
Задача 2
После первого вызова fib_lru(15) с декоратором @functools.lru_cache(maxsize=None) на пустом кэше вы проверяете fib_lru.cache_info(). Чему равно значение поля misses?
Задача 3
Разбиение строки на слова из словаря
Дана строка s из строчных латинских букв и словарь допустимых слов. Строку нужно полностью, без пропусков, разбить на последовательность слов из словаря. Каждое словарное слово разрешено использовать любое число раз.
Два разбиения различаются, если последовательности слов в них различаются. Например, строку abab со словарём a, b, ab, aba можно разбить пятью способами:
a + b + a + b;a + b + ab;ab + a + b;ab + ab;aba + b.
Найдите число полных разбиений строки. Если ни одного нет, выведите 0.
Формат ввода
В первой строке записана непустая строка s (1 ≤ |s| ≤ 80), состоящая из строчных латинских букв.
Во второй строке записано целое число k (1 ≤ k ≤ 20) — количество слов в словаре.
В следующих k строках записано по одному непустому слову из строчных латинских букв (1 ≤ |word| ≤ 20). Все слова словаря различны.
Формат вывода
Выведите одно целое число — количество полных разбиений строки s на слова из словаря.
Без регистрации. Гостевая проверка не сохраняет прогресс. Для сохранения перейдите к уроку.
Отправьте решение, чтобы увидеть результаты тестов.
Задача 4
Монтажник световых гирлянд
Каждый декабрь городской электрик Матвей берётся за самую ответственную часть праздничного убранства — световые гирлянды вдоль главной аллеи. Гирлянда состоит из нескольких секций, следующих друг за другом, и для каждой секции поставщик предлагает несколько вариантов цветных ламп, причём цена установки зависит как от номера секции, так и от выбранного цвета.
Однако у Матвея есть строгое техническое ограничение: если две соседние секции окрашены в один и тот же цвет, контакт между ними перегревается, что грозит коротким замыканием. Поэтому каждая пара рядом стоящих секций обязана иметь разные цвета — без каких-либо исключений.
Городской бюджет на праздничное оформление невелик, и Матвей хочет подобрать цвета так, чтобы суммарная стоимость установки всей гирлянды оказалась как можно меньше. При этом заказчик требует предоставить точную документацию: какой именно цвет был выбран для каждой секции, причём документация должна описывать единственную раскраску с минимальной стоимостью.
Помогите Матвею найти эту минимальную стоимость и восстановить соответствующую оптимальную раскраску гирлянды.
Формат ввода
В первой строке даны n и k (1 ≤ n, 2 ≤ k, n·k ≤ 300 000). Далее дана таблица: в строке i записаны стоимости k цветов для секции i. Все стоимости положительны. Оптимальная раскраска гарантированно единственная.
Формат вывода
Выведите минимальную стоимость, затем номера цветов секций от 1 до k.
Пример
Ввод:
3 2
1 9
5 1
1 9
Вывод:
3
1 2 1
Пояснение
Первая и третья секции получают цвет 1, средняя — цвет 2.
Без регистрации. Гостевая проверка не сохраняет прогресс. Для сохранения перейдите к уроку.
Отправьте решение, чтобы увидеть результаты тестов.
Продолжить с сохранением прогресса
Перейдите к уроку в учебном кабинете.

